当 AI 能力持续跃升,真正拉开企业差距的,不是谁先拿到最强模型,而是谁能把不均衡的能力转化为稳定、可治理、可衡量的业务结果。
一边是 AI 实验室不断刷新模型能力边界,关于通用人工智能(AGI)即将到来的预测此起彼伏;另一边,学术共同体对“继续扩大当前技术路径能否通向 AGI”仍保持审慎。
AAAI 2025 总统小组报告显示,在 475 份社区调查回应中,76% 的受访者认为,扩大当前 AI 研究路径“不太可能”或“非常不可能”实现 AGI。与此同时,77% 的受访者更优先考虑设计具有可接受风险收益比的 AI 系统,而不是直接追求 AGI。
这并不意味着 AI 发展正在放缓。METR 对前沿模型的研究显示,AI Agent 能以 50% 成功率完成的任务时长,在相关软件工程任务基准上曾呈现约每 7 个月翻倍的趋势。AI 能做的事情越来越多,但这种进步并没有平均分布到所有任务和工作场景。
企业经营端的差异更加明显。McKinsey 2026 年《The State of AI》调研中,80% 的受访者表示 AI 提升了个人工作效率,50% 认为 AI 帮助他们做出更好的决策;但只有 37% 的受访者表示 AI 已为所在组织带来一定程度的 EBIT 正向影响,达到其定义的 AI 高绩效标准的企业约占 6%。
这几组数据揭示了一个值得企业重新审视的现实:
AI 能力在加速,但能力提升不会自动转化为组织效率,更不会自动转化为企业利润。
对企业管理者而言,AGI 究竟会在几年后到来,或许仍没有确定答案。但有一件事已经足够明确:AI 在不同任务上的能力并不均衡,企业能否识别、管理并持续调整这条能力边界,将直接影响 AI 投资的回报。
BCG Institute 在 2026 年发布的《What CEOs Need to Know About Artificial General Intelligence》中,将这种不均衡称为 Jagged Frontier(锯齿前沿)。它所提出的关键问题,不是企业应该等待哪一代模型,而是如何让组织持续适应一条不断移动、却始终不够平整的 AI 能力边界。
一、AGI 时间表之争:真正的分歧不是 AI 是否进步
AGI 尚无统一的行业定义。BCG 在其研究中,将 AGI 描述为:在全部人类认知能力范围内,都达到大师级深度与胜任力的技术。按照这一标准,AGI 并不是今天已经实现的技术。
围绕当前大语言模型(LLM)能否通过持续扩展走向 AGI,业界大致存在三种判断:
· 扩展路径乐观派:认为增加算力、数据和训练规模,能够持续推动模型能力提升,最终逼近通用智能。
· 扩展与架构创新并重派:认为规模化仍然重要,但还需要在推理、记忆、持续学习等方面取得关键突破。
· 新架构探索派:认为当前 LLM 架构可能存在难以跨越的边界,通往 AGI 或许需要不同的技术范式。
AAAI 2025 总统小组报告为这场争论提供了学术界的一个观察窗口。该报告由 25 位 AI 研究者撰写、15 位贡献者支持,并收集了 475 份社区调查回应,其中约 20% 来自学生,67% 的受访者主要来自学术界。
调查中,76% 的受访者认为扩大当前 AI 研究路径难以实现 AGI;77% 更优先考虑具有可接受风险收益比的 AI 系统设计,而不是直接追求 AGI。
需要注意的是,这是一项社区意见调查,并不等同于对 AGI 技术路线的正式科学裁决。它所反映的是:在 AI 研究共同体内部,对当前技术路径的能力边界、风险和长期可行性仍存在审慎判断。
因此,企业不必简单地在“AGI 很快到来”和“AGI 遥遥无期”之间选边。更重要的是区分两个问题:
第一,模型能力是否还会快速提升? 现有研究已经给出大量肯定证据。
第二,模型能力能否同步覆盖所有复杂工作,并在真实组织中稳定创造价值? 目前并没有证据支持这样的推断。
两者并不矛盾。AI 可以在代码生成、信息检索、内容生产等任务上快速进步,同时仍然难以独立承担复杂决策、跨部门协调、长期责任和高度依赖组织背景的工作。
企业战略不应建立在对 AGI 日期的猜测上,而应建立在对当前能力边界的持续测量之上。
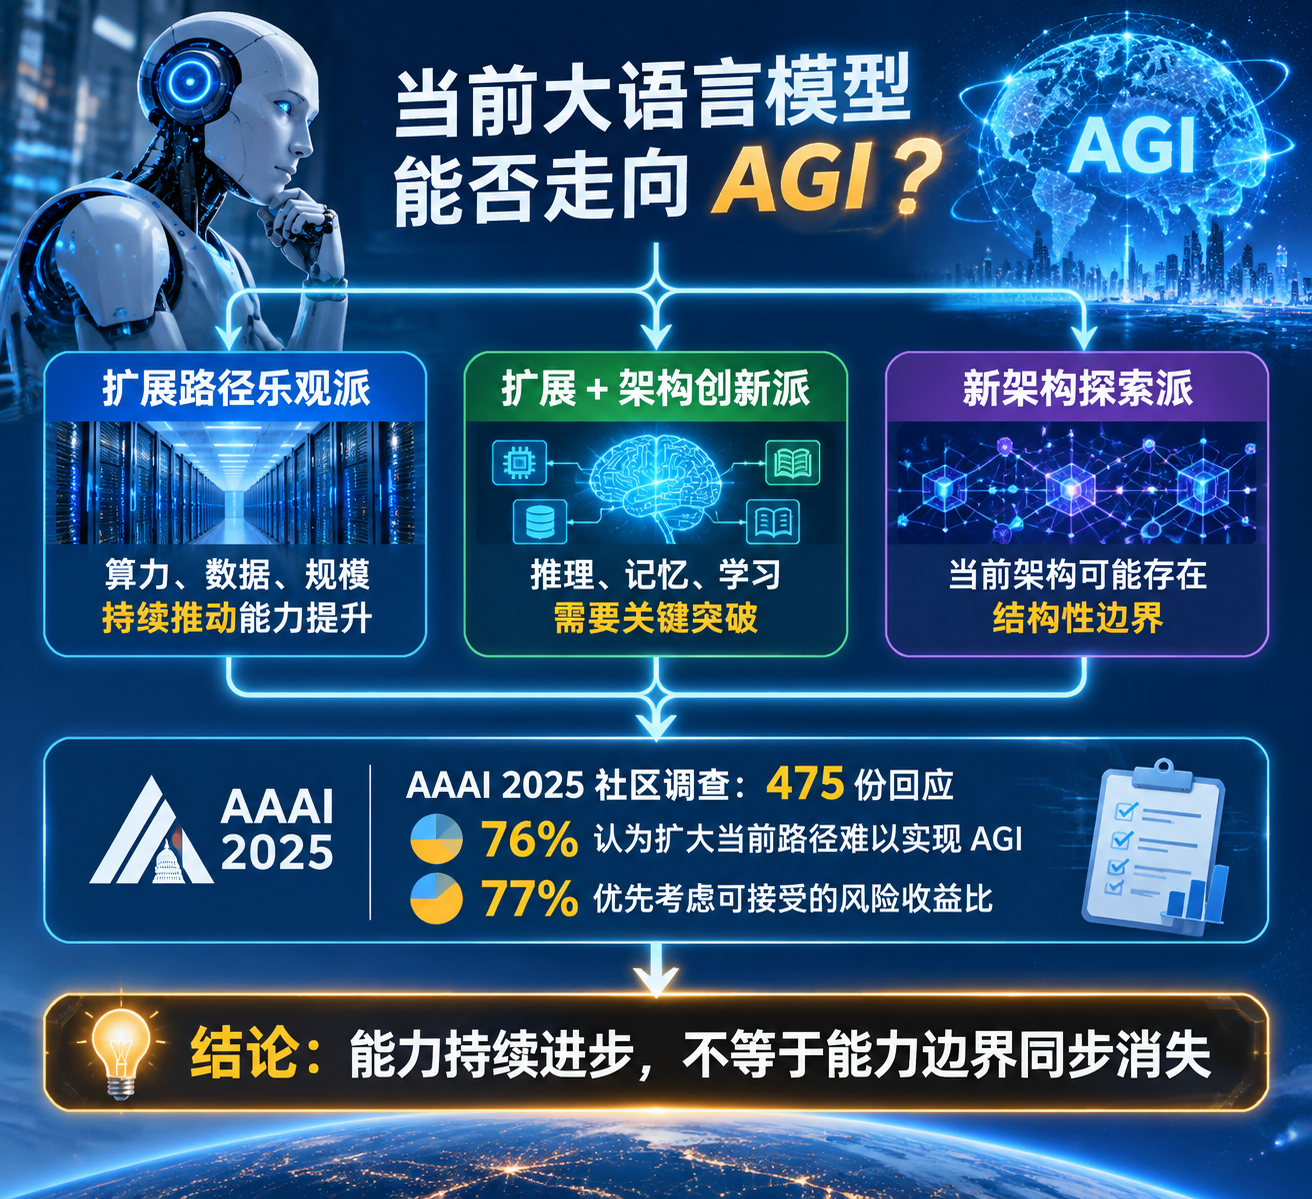
图 1|AGI 路径的三种判断
二、锯齿前沿:AI 越来越强,为什么仍然不能接管整个岗位?
2023 年,BCG Institute 与多所领先学术机构的研究者提出了“锯齿前沿”这一概念,用来描述 AI 在不同任务上的能力差异:
AI 在某些任务上已经达到专家甚至大师水平,在另一些任务上表现高于平均水平,但在其他任务上仍可能低于普通专业人员。
这条能力边界并不是一条平滑曲线,而更像一排高低不齐的锯齿。
以软件工程为例,AI 已经能够高效完成代码生成、测试编写、代码重构等工作,但系统架构取舍、跨团队协商、复杂故障处理、业务目标判断和最终责任承担,仍然需要人类发挥重要作用。
同样的差异也出现在法律和医疗领域。
在法律工作中,文档审阅、资料检索、证据整理等任务更容易被 AI 辅助;但庭审策略、客户沟通、复杂利益权衡和法律责任判断,并不能简单地交给模型。
在医疗工作中,病历整理、临床文档、编码和信息检索可以获得 AI 支持;但复杂诊断、医患沟通、治疗决策以及医疗责任,仍需要专业人员参与。
因此,岗位并不是一个可以整体交给 AI 的标准化任务包。一个岗位内部往往同时包含大量可自动化、可辅助和必须由人负责的任务。
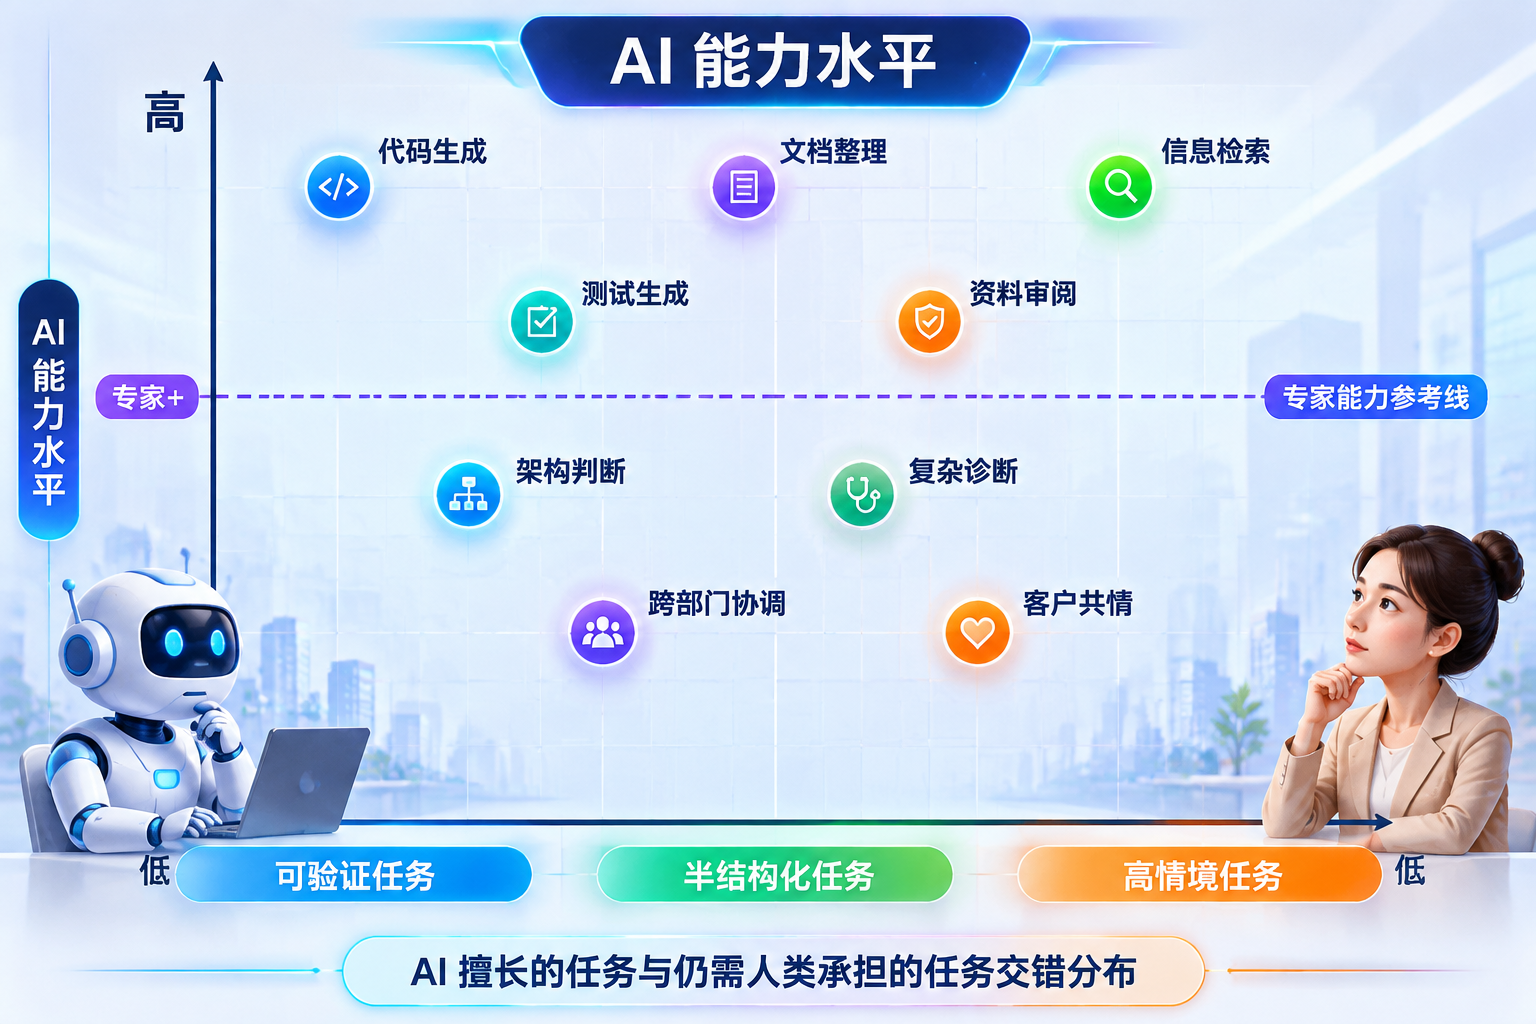
图 2|同一个岗位内部,AI 能力呈现锯齿状分布
BCG 在 2026 年的研究中,以诉讼律师、门诊初级保健医生和软件工程师等岗位为例,展示了 AI 在具体任务上的能力差异。其软件工程师任务分析还比较了 2024 年中与 2026 年中的能力变化:AI 在代码编写、测试、重构等任务上进步显著,但在架构权衡、跨团队协作和责任判断等方面仍存在边界。
这意味着,AI 越强,企业越需要精细地拆解工作,而不是简单地按照岗位名称判断哪些人会被替代。
企业真正需要重画的,不是岗位编制表,而是任务分工图。
一个销售岗位可能包含线索识别、客户研究、需求分析、方案撰写、商务谈判和关系维护。AI 可以承担其中一部分信息处理与内容生产任务,但客户信任、复杂需求判断和关键商务决策仍需要人的参与。
一个营销岗位也可能同时包含市场洞察、内容生产、渠道投放、线索培育、效果分析和预算决策。不同任务的可自动化程度并不相同。
如果企业只是采购一批 AI 工具,让员工在原有流程中增加一个对话窗口,最终得到的可能只是局部提效,而不是组织生产方式的改变。
能力增长的另一面:收益并不平均
锯齿前沿不仅存在于不同任务之间,也存在于不同员工、不同工作环境和不同组织之间。
METR:Agent 能力持续扩展,但基准之间存在明显差异。
METR 使用“50% 时间地平线”衡量 AI Agent 的能力,即模型能够以 50% 成功率自主完成、按人类完成时间衡量的任务长度。其研究发现,在相关软件工程任务基准上,这一时间地平线呈现出约每 7 个月翻倍的趋势。
后续跨领域研究也显示,不同任务领域的时间地平线和增长速度存在较大差异。代码、数学和部分科学问答任务上的 Agent 能力进步较快,而图形界面操作、自动驾驶等领域的进展并不相同。
这说明,不能仅凭一个综合 Benchmark 分数,就推断 AI 已经具备在所有业务场景中稳定执行任务的能力。
NBER:AI 对不同经验层级员工的帮助并不相同。
Brynjolfsson、Li 和 Raymond 对 5,179 名客服人员开展的研究发现,使用生成式 AI 助手后,员工每小时解决的问题数量平均提高约 14%;对于新手和低技能员工,生产率提升约 34%。
这项研究的重要意义在于,AI 不只是替代劳动,也可能通过提供实时建议、传播优秀员工的工作方法,帮助经验较少的员工更快达到较高水平。
但这并不意味着所有员工都能获得相同幅度的收益。AI 的效果取决于任务性质、员工经验和工具与工作流程的匹配程度。
OECD:企业 AI 采用率快速提升,就业影响仍然是多种力量共同作用的结果。
OECD 2026 年公布的数据表明,在有可比数据的成员国企业中,AI 使用率从 2023 年的 8.7% 上升到 2024 年的 14.2%,并在 2025 年达到 20.2%。两年间,企业 AI 使用率超过翻倍。
但 AI 对就业的影响并非只有“替代”一条路径。自动化会减少部分任务需求,生产率提升可能扩大业务规模,新任务和新岗位也可能随之出现。最终的就业结果,取决于这些力量如何相互作用。
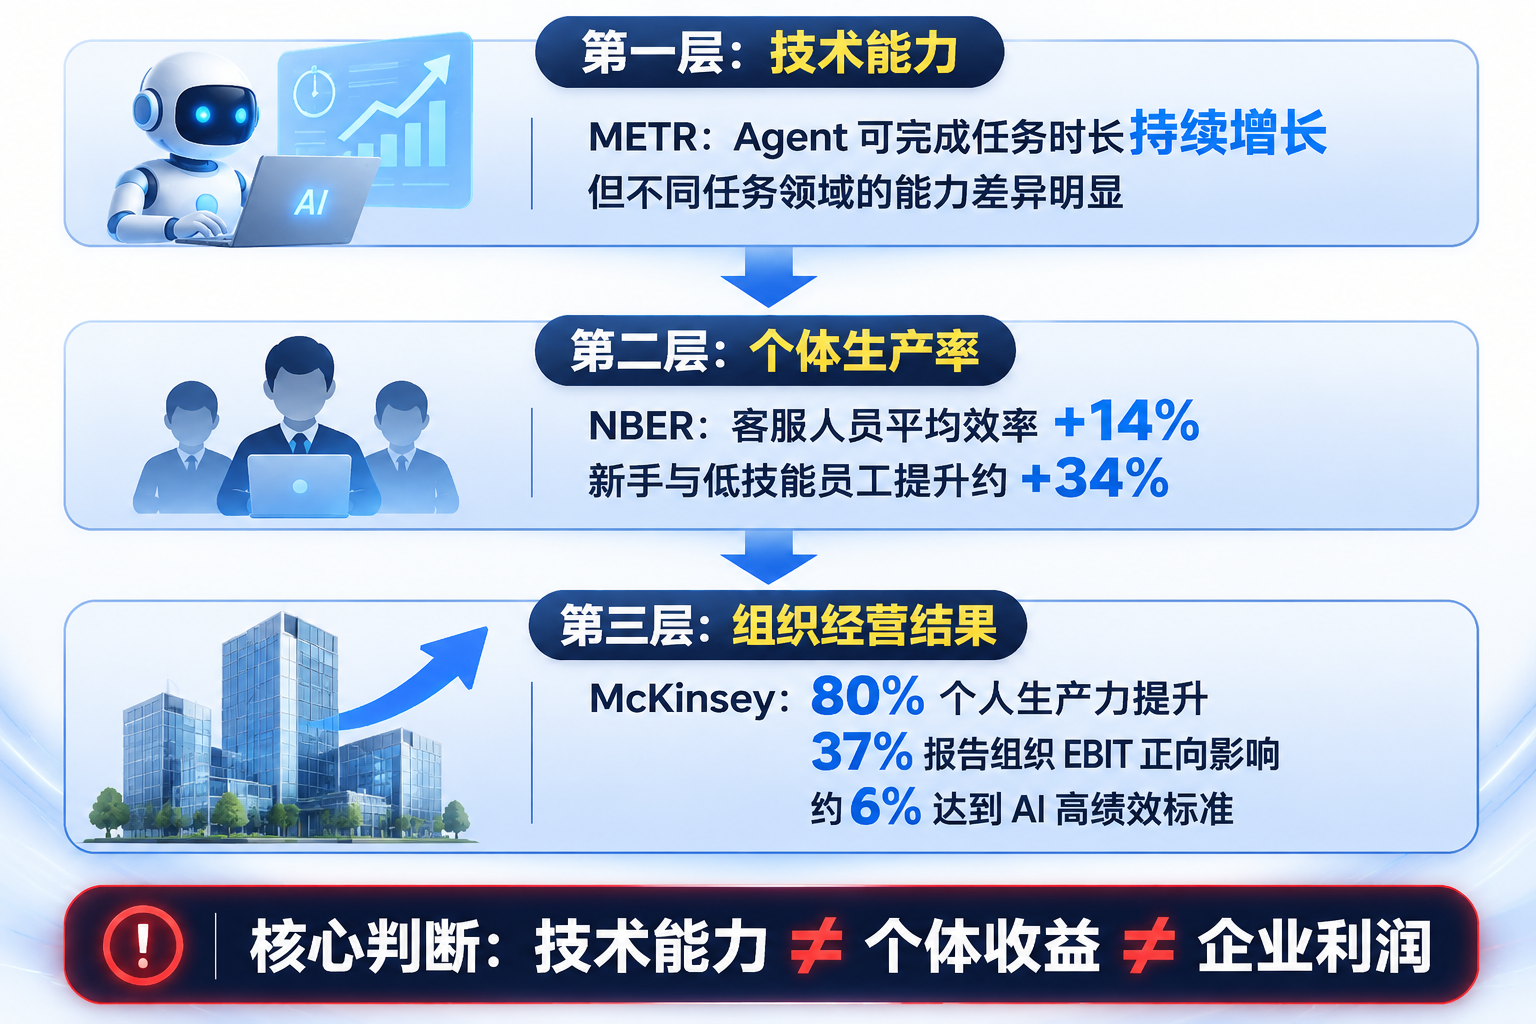
图 3|AI 价值形成的三个层次
由此可以得到一个重要结论:AI 不是简单的效率放大器,而是一种重新分配任务和能力的生产力工具。
企业要获得更稳定的收益,需要同步调整知识管理、业务流程、岗位职责、培训机制和质量控制体系。否则,模型能力提升得越快,工具与组织之间的错配也可能越明显。
三、四道技术瓶颈:为什么锯齿前沿可能长期存在?
锯齿前沿并不一定只是模型暂时不够强造成的工程问题。BCG 对 LLM 架构的分析指出,至少有四类因素可能使 AI 能力的不均衡长期存在。
1. 高质量训练数据并非无限
早期大语言模型能力提升,很大程度上来自训练数据规模的扩大。但高质量、易获取的人类公开文本并不是无限资源。
当模型不断扩大训练规模,数据质量、数据重复、信息时效性和训练效率都会成为需要解决的问题。
合成数据、真实交互数据和专业领域数据可以提供新的训练来源,但它们也带来数据质量、偏差控制和评估有效性等新问题。
因此,继续扩大数据规模并不意味着所有能力都会按照相同比例提升。
2. 可验证奖励强化学习存在适用边界
近期 AI 推理和 Agent 能力的进步,与强化学习中的可验证奖励机制(RLVR)密切相关。
其基本思路是:让模型反复尝试完成任务,并根据结果是否正确给予奖励。只要任务结果可以低成本、可靠地验证,模型就能够通过大量试错持续改进。
数学题、代码测试等任务具有相对明确的判断标准,因此更适合这类训练方法。
但企业经营中的大量问题并没有即时、客观、唯一的答案。
例如:
· 个新产品是否值得上市,需要市场反馈来验证;
· 一项营销策略是否有效,需要观察长期转化和客户价值;
· 一个投资决策是否正确,可能需要数年才能判断;
· 一次组织调整是否成功,还涉及员工行为、协作效率和长期经营表现。
这些问题的反馈周期长、评价标准复杂,甚至存在多种合理答案。
AI 容易在“答案可以被验证”的任务上持续进步,却未必能以同样方式掌握“答案需要长期经营验证”的任务。
3. 模型尚不能像员工一样持续在岗学习
一个新员工进入企业后,需要通过会议、项目、客户沟通和跨部门协作,逐渐理解公司的历史、文化、业务规则和决策方式。
这些知识并不全部写在制度文件里。相当一部分属于组织隐性知识。
今天的 LLM 可以通过检索、上下文、工具和外部记忆访问新的组织信息,但这与员工在实际工作中持续形成稳定经验,并不是同一回事。
模型在执行任务时通常不会自动更新自身参数,也不能仅凭一次交互就保证形成长期可靠的组织认知。
企业因此需要建立自己的知识管理与上下文工程体系,把散落在业务系统、会议记录、客户互动、流程文件和员工经验中的信息,转化为可检索、可更新、可授权调用的组织资产。
4. 算力、能源与硬件存在物理约束
算力投入能够推动模型能力提升,但算力并非没有成本和上限。
大型训练和推理系统需要芯片、数据中心、电力供应、冷却设施和高速网络等基础设施。电网容量、能源成本、半导体供应和数据中心建设周期,都可能影响算力扩张速度。
即使技术路线在理论上可行,实际部署也必须考虑能源、成本和基础设施的约束。
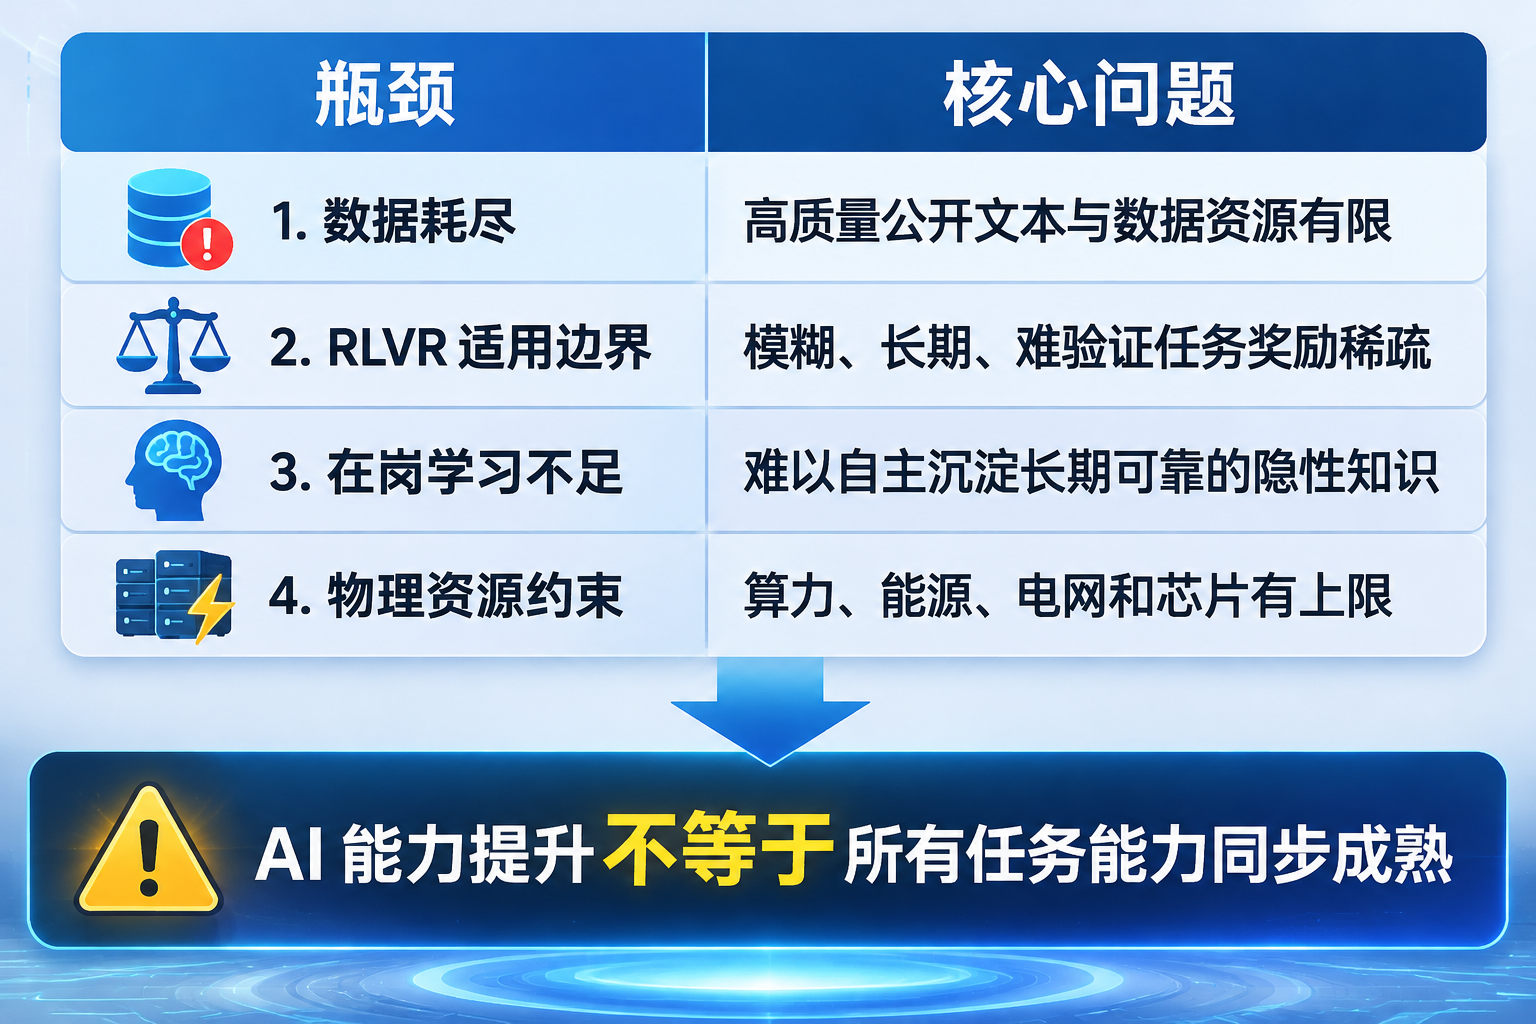
图 4|LLM 通往通用智能的四道结构性瓶颈
从实验室到真实生产:可验证任务不等于复杂业务
软件开发是观察 AI 能力与真实生产效率差异的典型场景。
GitHub Copilot 的一项受控实验显示,在完成一个边界清晰的 JavaScript HTTP 服务器编写任务时,使用 AI 辅助的开发者比对照组快 55.8%。
但在真实的软件工程环境中,结果并不总是如此。
METR 于 2025 年开展的一项随机对照试验,邀请 16 名有经验的开源开发者,在他们长期参与的成熟代码仓库中完成 246 项真实任务。研究发现,在允许使用当时的 AI 工具时,开发者完成任务的时间反而增加了 19%。
这项研究并不能证明 AI 会普遍降低软件开发效率。METR 也明确提醒,研究样本和场景有限,结果不能直接推广到所有开发者和软件工程任务。
它真正揭示的是一个重要问题:基准测试中的能力表现,与真实工作环境中的净生产率之间,存在需要认真评估的距离。
实验任务通常边界清晰、上下文有限、结果容易验证;真实生产环境则包含历史代码、系统依赖、隐性约定、代码审查、质量要求和团队协作。
AI 生成一段代码,并不等于这段代码能够顺利进入生产系统;Agent 完成一个步骤,也不等于整个业务流程已经闭环。
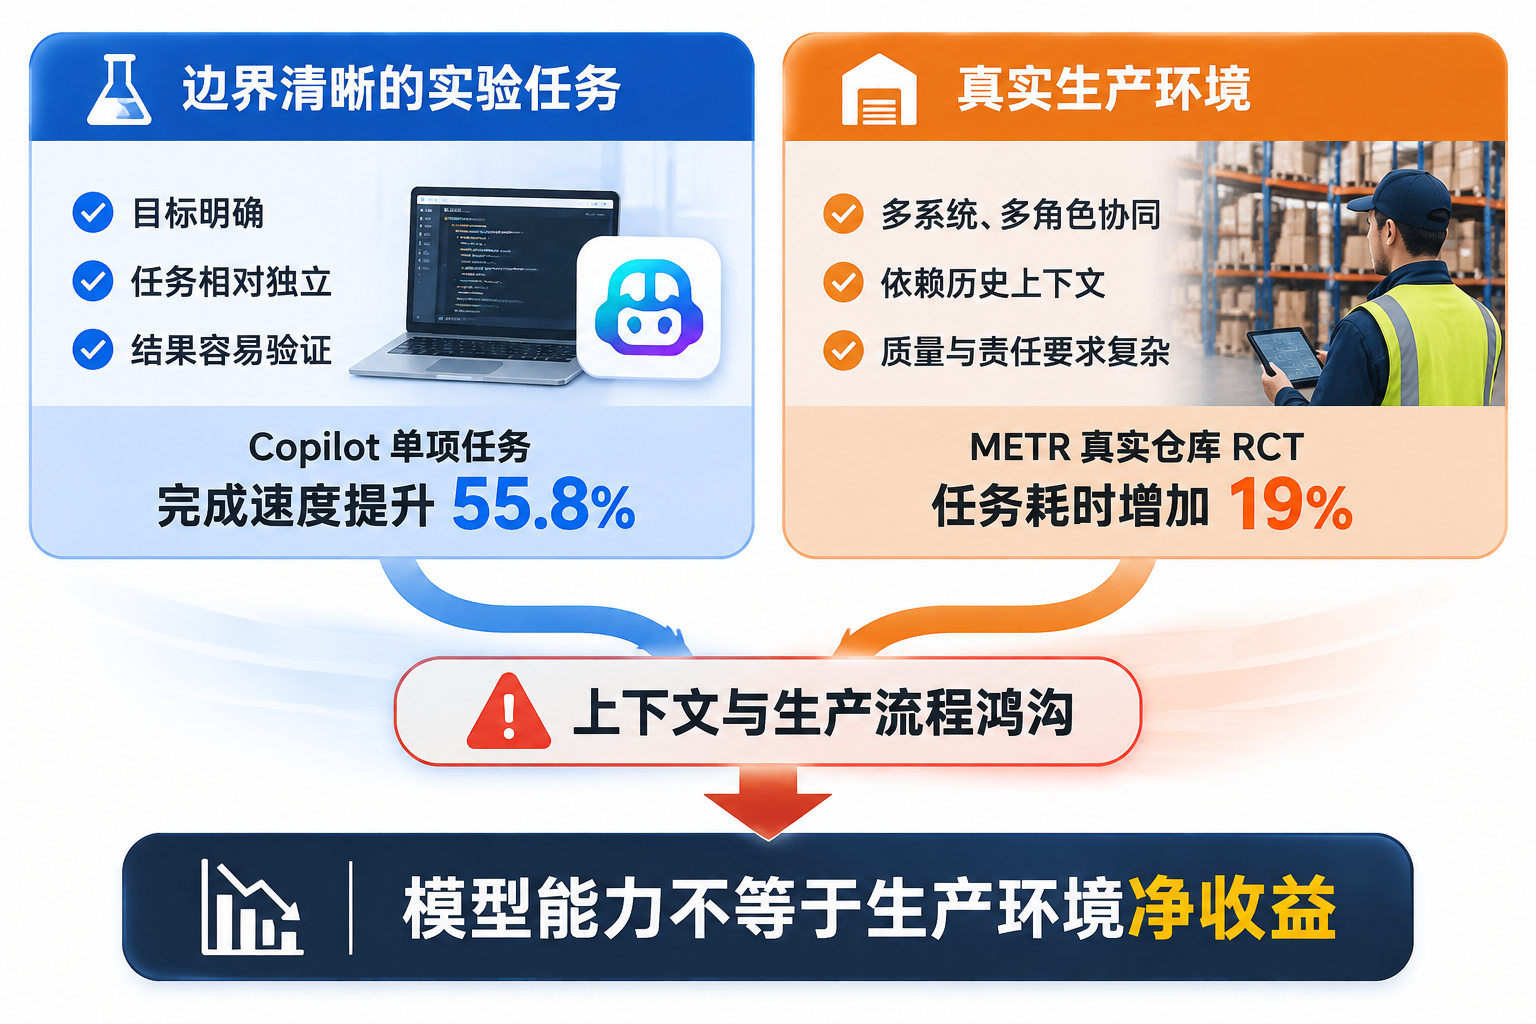
图 5|实验室任务与真实生产环境之间的差距
企业需要建立的,不只是模型调用能力,还包括任务拆解、上下文管理、工具连接、权限控制、质量评估和异常处理机制。
四、即使 AGI 到来,最强模型也未必人人可用
企业评估 AI 时,除了关注模型“能不能做到”,还必须关注模型“能不能稳定获得”。
技术能力与商业可获得性之间,存在一道由监管、国家安全、数据治理和供应链共同构成的边界。
在高敏感行业,企业选择 AI 系统时,通常不仅考虑模型性能,还需要评估:
· 数据是否允许跨境传输;
· 是否支持私有化部署或专属环境;
· 是否具备完整的审计日志;
· 是否能够进行细粒度权限隔离;
· 是否满足行业监管与数据安全要求;
· 供应商是否具备持续服务能力;
· 模型、算力和关键组件是否存在供应链风险。
金融、医疗、制造和公共服务等行业尤其如此。一个在公开基准上表现最强的模型,如果无法满足企业的数据、合规、部署和审计要求,就不一定是实际可用的最优选择。
因此,企业需要区分三个概念:
· 模型能力: 模型理论上能够完成什么任务。
· 产品可用性: 企业能否以可接受的成本、延迟和稳定性使用它。
· 生产可控性: 企业能否管理数据、权限、风险、审计和业务责任。
这三个维度共同决定了 AI 能否进入核心业务流程。
最强模型,不一定是最适合企业长期依赖的模型。
企业的 AI 架构需要保持一定的模型可替换性,避免将核心业务流程绑定在单一模型、单一供应商或单一部署方式上。
五、帕斯卡赌注:企业不应该等待 AGI,而应该准备好迎接能力变化
面对 AGI 到来的时间和影响都高度不确定的局面,BCG 借用了法国数学家布莱兹·帕斯卡提出的“帕斯卡赌注”思路。
当决策结果不确定、不同结果之间的影响差异巨大,而且企业无法回避选择时,管理者应该寻找具有更高长期价值的行动方案。
将这一思路应用于企业 AI 战略,可以形成一个简单的决策矩阵。
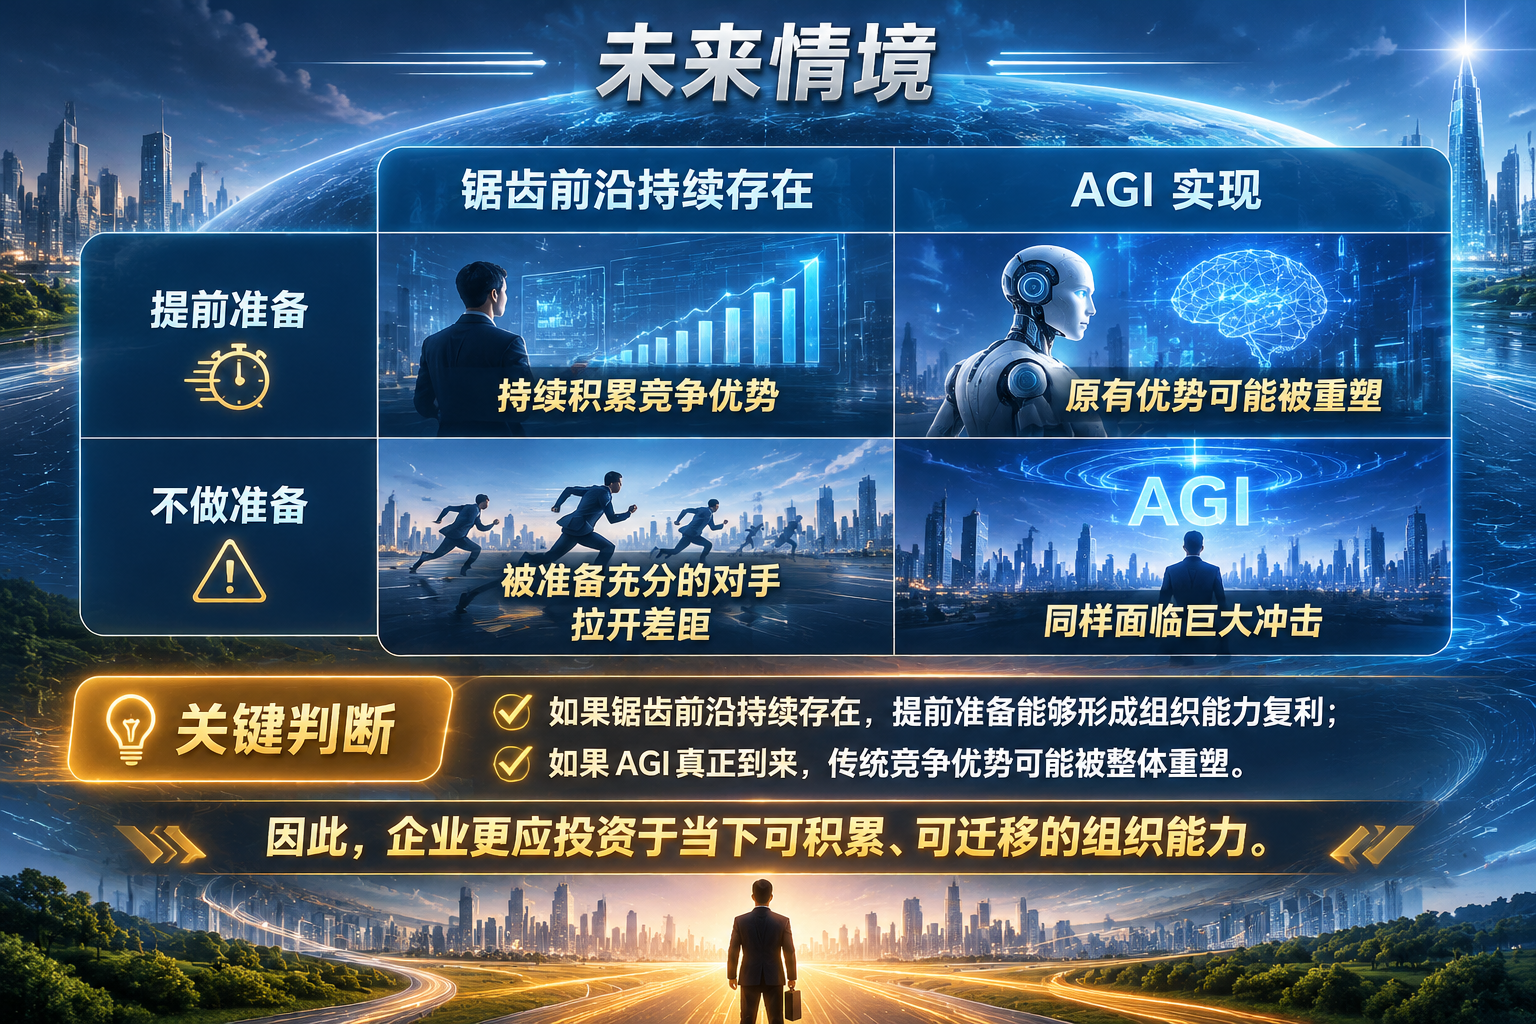
图 6|企业 AI 战略的两种未来情境
这一逻辑并不是说企业能够提前为所有 AGI 情境做好准备,而是强调:在当前可观察的技术条件下,重构流程、沉淀知识、培养人才和建立治理能力,都是可以立即行动的事情。
如果未来模型能力继续呈现锯齿状,这些投入能够帮助企业持续扩大优势;如果模型能力发生重大跃迁,具备数据治理、组织适应和快速重构能力的企业,也更有条件应对变化。
McKinsey 2026 年调研进一步说明了为什么组织重构如此重要。
在 97 个国家和地区、1,719 名受访者参与的调查中:
· 80% 的受访者表示 AI 提升了个人生产力;
· 50% 表示 AI 帮助他们做出更好的决策;
· 37% 表示 AI 已为组织带来一定程度的 EBIT 正向影响;
· 约 6% 的企业达到 McKinsey 定义的 AI 高绩效标准,即 AI 对 EBIT 贡献达到至少 5%,且影响被评价为显著。
更值得关注的是高绩效企业的共同特征:近四分之三表示已经因 AI 从根本上重新设计工作流程,而其他企业中这一比例约为四分之一。
这说明企业 AI 价值的分水岭,不是员工是否开始使用 AI,而是企业是否围绕 AI 重新设计了工作。
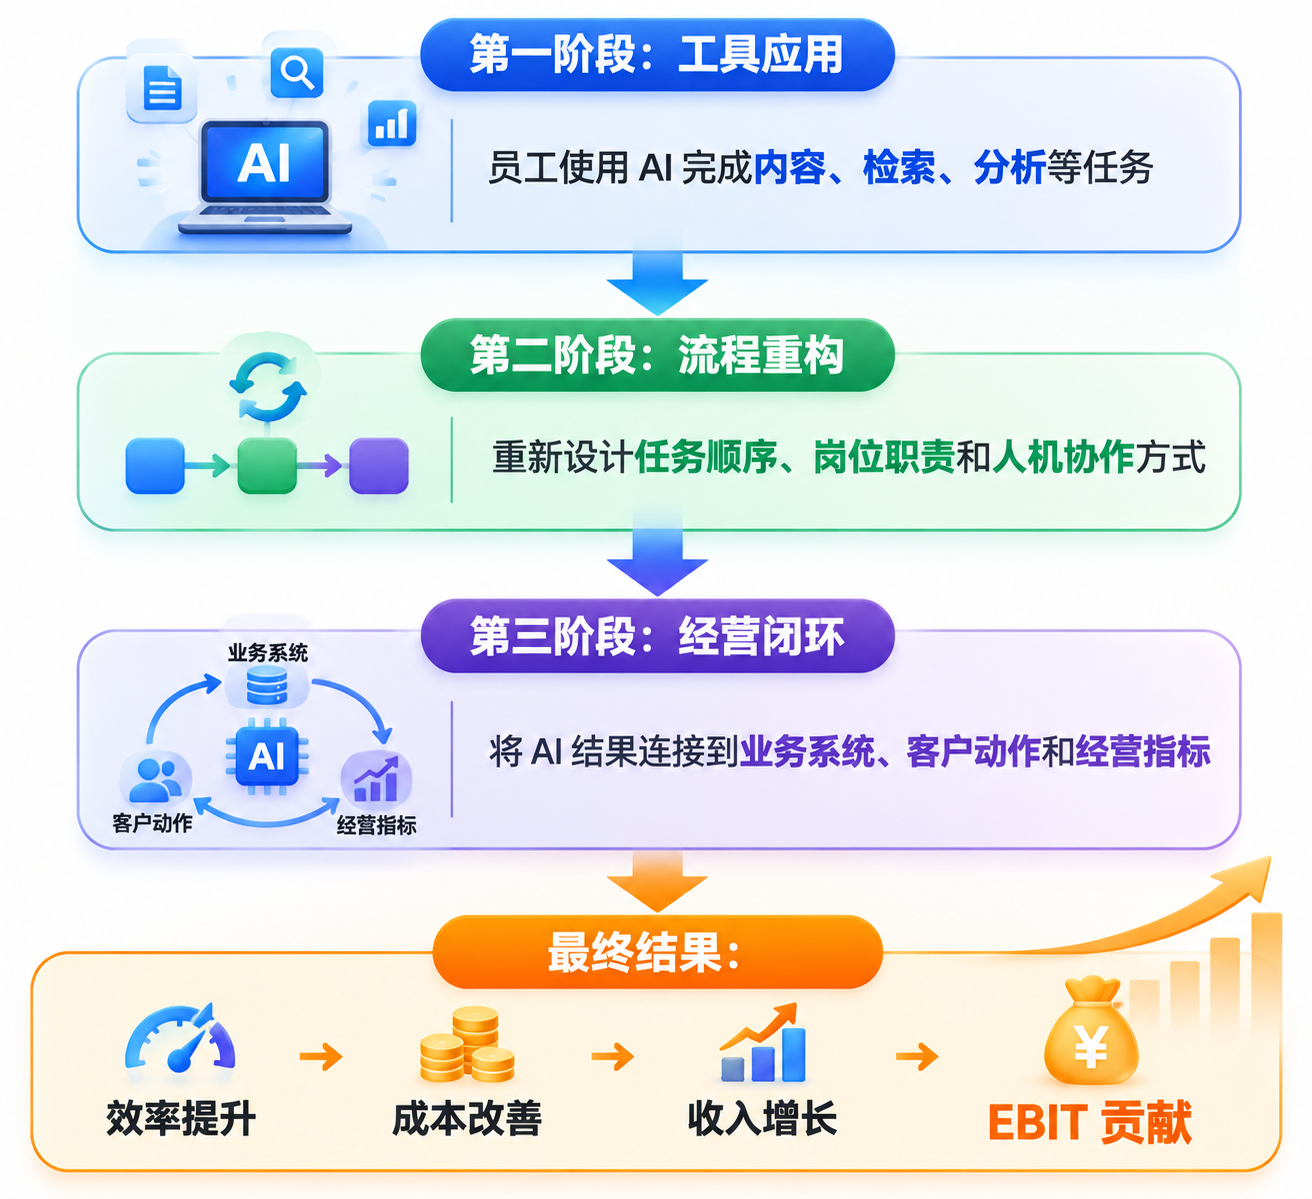
从个人提效到企业利润,需要跨越三道门槛
企业如果只停留在第一阶段,得到的往往是分散的个人效率收益;只有进入流程重构和经营闭环,才有机会把局部效率转化为可持续的组织收益。
六、Token-based Competition:当所有企业都能使用强模型,竞争优势来自哪里?
当基础模型逐渐成为可采购、可调用的通用能力,企业之间的竞争就会发生变化。
BCG 将这种趋势称为 Token-based Competition(基于 Token 的竞争)。
其核心判断是:当企业都能够使用相近水平的模型,并以相近的方式获得 Token,模型本身就不再是长期、稳定的差异化来源。
真正决定企业竞争力的,将是企业如何组织人、数据、流程和智能体,让同样的模型产生不同的经营结果。
这意味着,企业 AI 的竞争重点正在从“谁拥有更强的模型”,转向“谁能更好地使用模型完成业务”。
1. 市场资金正在流向应用层
Menlo Ventures 发布的《2025: The State of Generative AI in the Enterprise》显示,2025 年企业生成式 AI 支出达到 370 亿美元,高于 2024 年的 115 亿美元,约为上一年的 3.2 倍。
其中,AI 应用层支出达到 190 亿美元,占总支出的一半以上;基础设施层支出约 180 亿美元。
应用层进一步覆盖通用办公、部门级工具和垂直行业解决方案。这说明企业 AI 市场正在从基础模型能力建设,进一步走向具体业务场景的落地。
需要强调的是,Menlo 的统计属于其对企业生成式 AI 市场支出的估算,并非所有企业 AI 投入的统一官方统计。但其结构性信号值得关注:企业愿意为能够直接进入工作流程、带来可感知价值的应用付费。
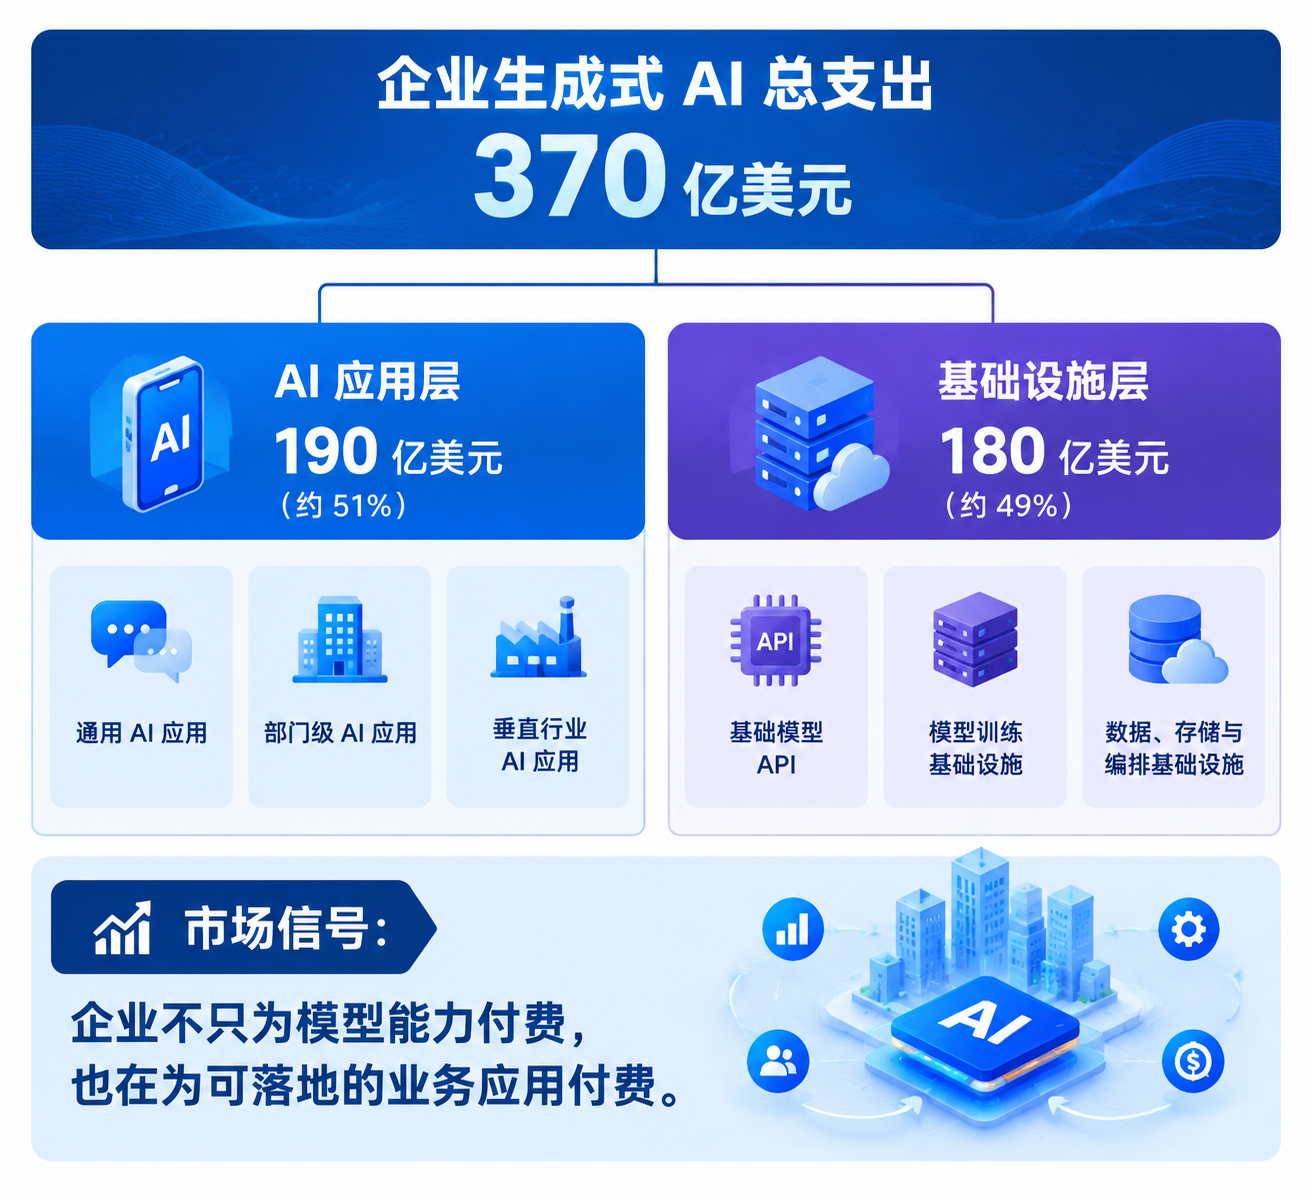
图 7|2025 年企业生成式 AI 支出结构
当应用层支出不断增长,企业真正需要的就不只是模型接口,而是能够把模型连接到业务数据、业务规则和业务动作的完整系统。
2. 企业 AI 价值不是简单的成功或失败,而是分阶段兑现
Deloitte《State of Generative AI in the Enterprise》调研覆盖 14 个国家的 2,773 位企业与技术管理者。
报告显示,超过三分之二的受访者预计,未来三到六个月内能够全面规模化的生成式 AI 实验项目占比不超过 30%。
但在最先进、已经规模化的项目中,74% 的受访者表示其 ROI 达到或超过预期,其中 43% 达到预期、31% 超过预期;20% 的受访者表示项目 ROI 超过 30%。
这两组数据并不矛盾。前者描述的是从实验到规模化的难度,后者描述的是已经进入规模化阶段的先进项目所取得的回报。
换句话说,AI 并不是没有商业价值,而是价值集中在少数能够跨越数据、流程、组织和度量门槛的企业中。
企业 AI 落地通常要经历四个阶段:
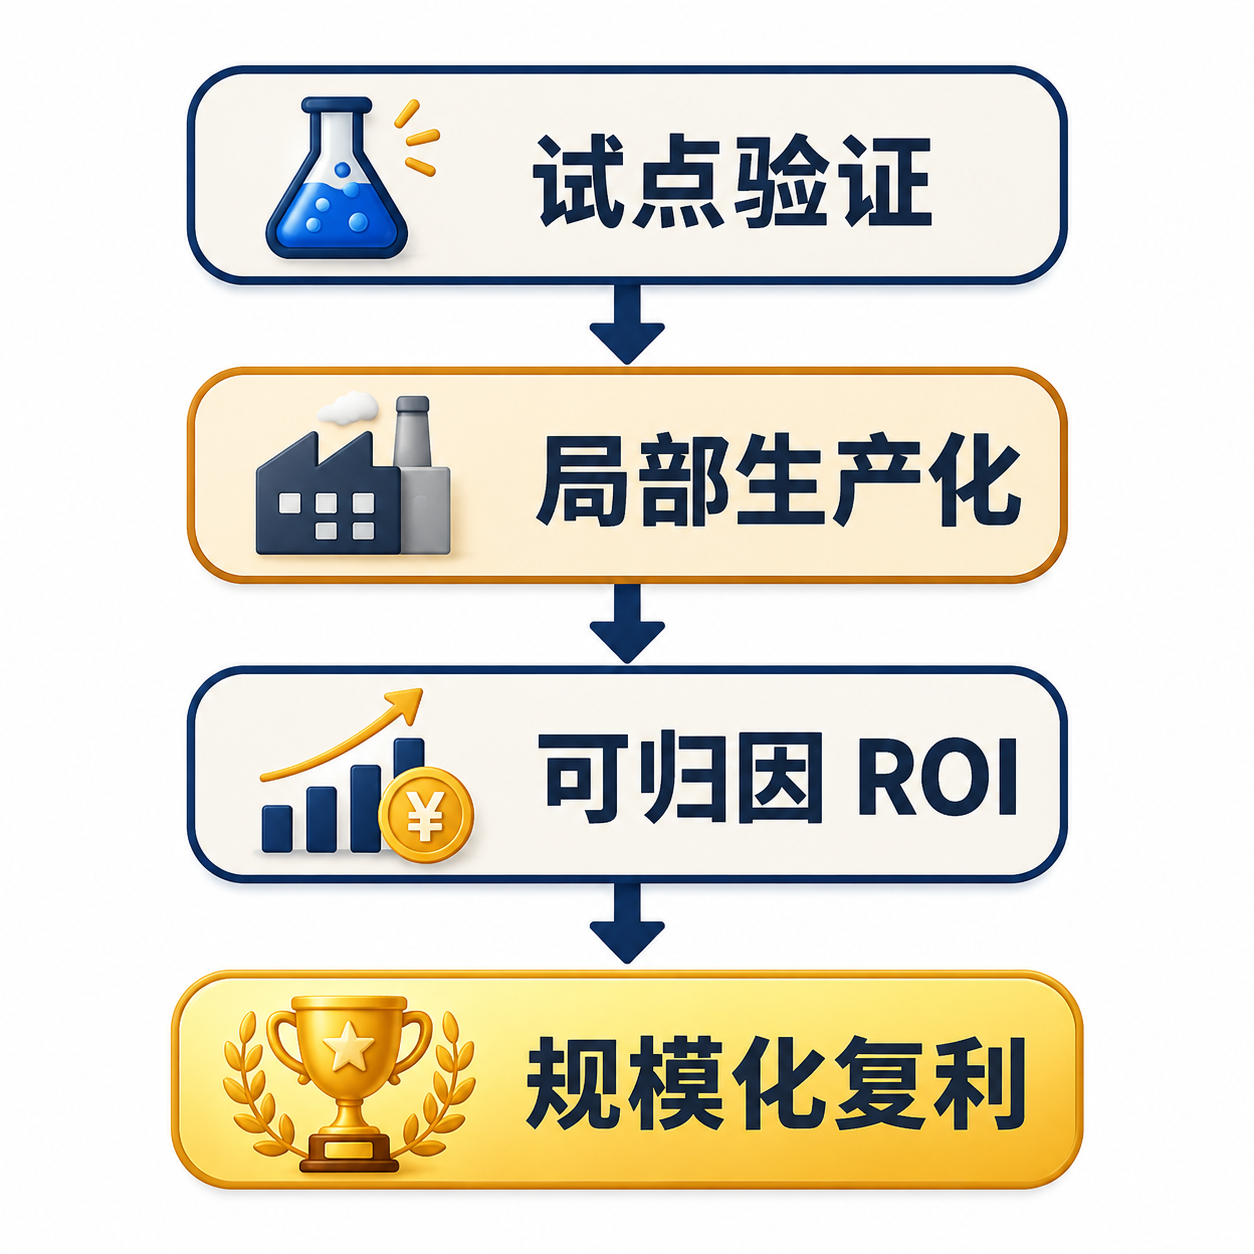
如果企业无法定义清晰的业务目标、无法获得可靠数据、无法把 AI 接入真实流程,也无法衡量投入产出,就很难从试点走向规模化。
3. Agent 基建正在进入淘汰赛
Agent 是将模型能力转化为业务动作的重要载体,但并不是所有 Agent 项目都值得投入。
Gartner 在 2025 年 6 月发布的预测指出,到 2027 年底,超过 40% 的 Agentic AI 项目可能被取消,主要原因包括成本不断上升、商业价值不清晰和风险控制不足。
Gartner 同时指出,许多项目仍处于早期实验或概念验证阶段;部分被称为 Agent 的产品,实际上只是对传统助手、聊天机器人或自动化工具进行重新包装。
这一预测并不意味着 Agent 技术没有前景,而是提醒企业:从能够演示到能够稳定生产,中间存在真实的工程和经营门槛。
企业级 Agent 系统至少需要解决五个问题:
· 任务可靠性:能否持续、稳定地完成目标任务,而不是只在演示中成功。
· 上下文准确性:能否获取正确的客户、产品、流程和组织信息。
· 权限与治理:能否遵守角色权限、业务规则和数据安全要求。
· 异常接管:执行失败、信息不足或风险超限时,能否及时转交人工处理。
· 价值度量:能否计算单位任务成本、完成率、响应时长和最终业务收益。
Agent 的竞争不能只看数量和自主程度,而应该看它能否在真实业务环境中持续创造价值。
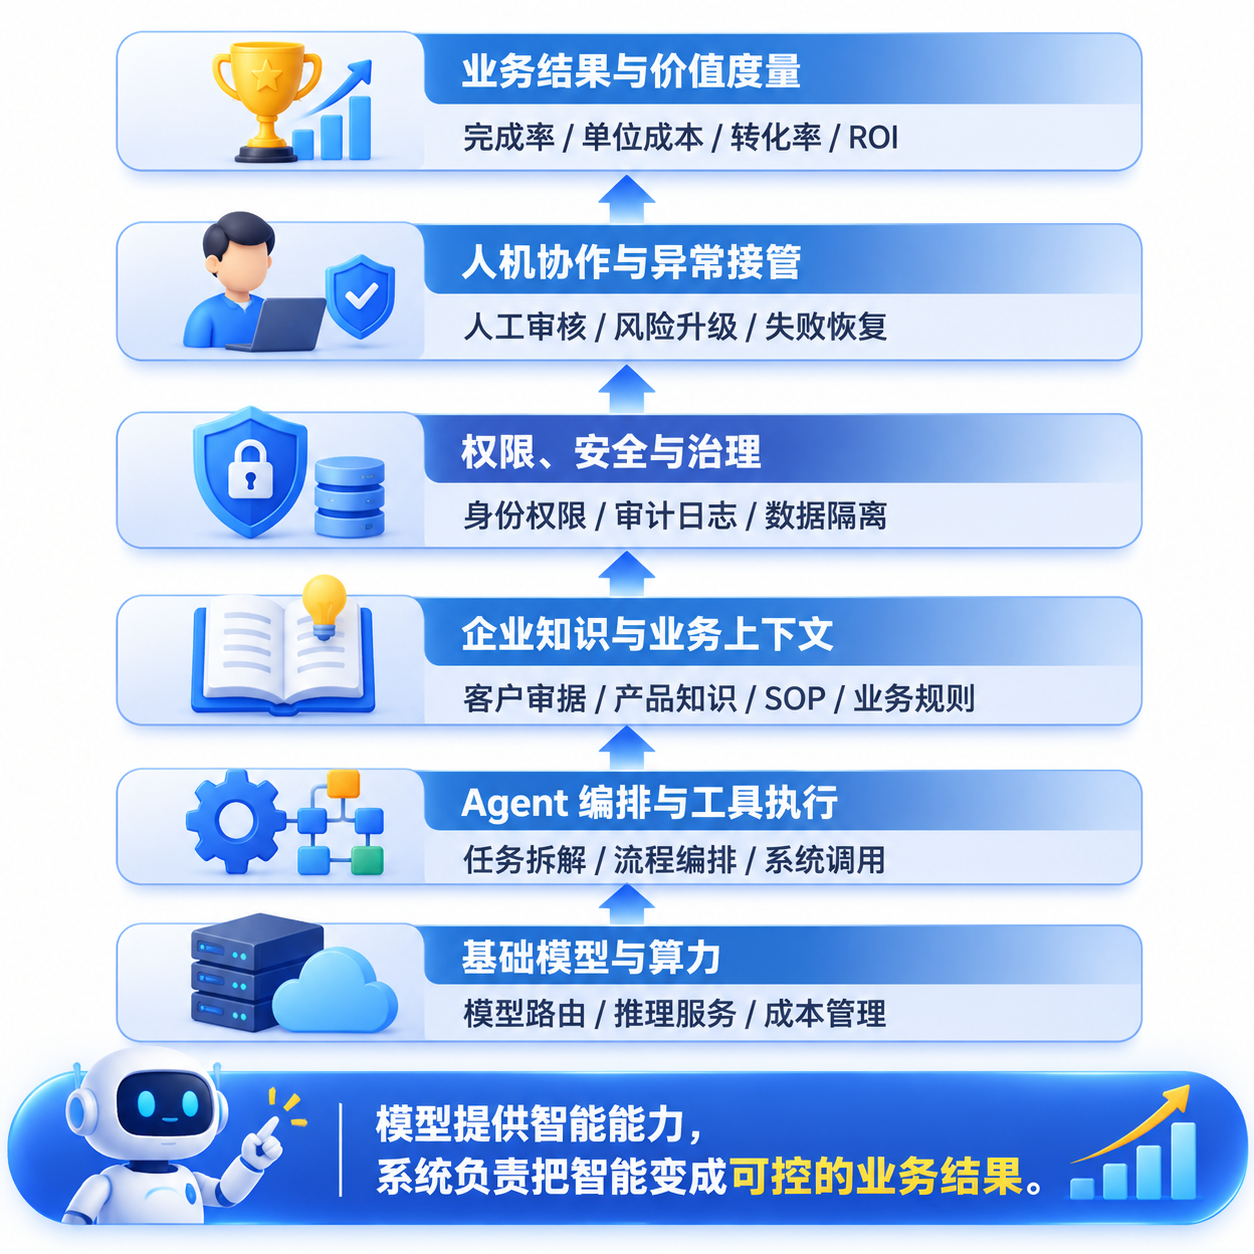
图 8|企业级 Agent 的生产化能力栈
EY 对 Agentic AI 价值的研究也强调,企业需要从完整运营体系看待 Agent 投资:价值并不只来自模型,还涉及算力、数据管道、治理、监督、流程重构和员工能力建设。
因此,企业级 Agent 平台的真正竞争力,不是生成了多少 Agent,而是能否把任务编排、知识管理、权限治理、异常接管和结果度量整合成可复用的生产系统。
4. 三个决定企业 AI 竞争力的命题
综合上述研究,可以提炼出三个判断:
第一,AI 是能力再分配机制,而不只是效率放大器。 它能够帮助部分员工更快完成任务,也会改变经验、技能和岗位价值的分布。企业需要重新设计培训、岗位和协作机制。
第二,企业 AI 的 ROI 取决于流程重构,而不是模型参数。 个人效率提升并不意味着企业利润同步增长。只有当 AI 被嵌入端到端业务流程,效率才有机会转化为经营结果。
第三,Agent 的核心竞争力是可治理的生产率。 能够完成任务只是起点,可靠性、权限、审计、成本、异常接管和业务归因,才决定它能否长期进入企业核心流程。
七、企业如何经营锯齿前沿:从任务分工到企业智能体基建
如果 AI 的能力边界长期呈现锯齿状,企业就不能把 AI 建设理解为一次性的模型采购或工具部署,而应该将其视为持续调整组织生产方式的过程。
企业需要建立一套能够随着模型进步而不断重绘的运营系统。
这套系统至少包含四个关键环节。
1. 任务级能力测绘:先识别哪些工作可以交给 AI
企业应当从岗位出发,进一步拆解具体任务,并按照任务复杂度、验证成本、风险水平和上下文依赖程度进行分类。
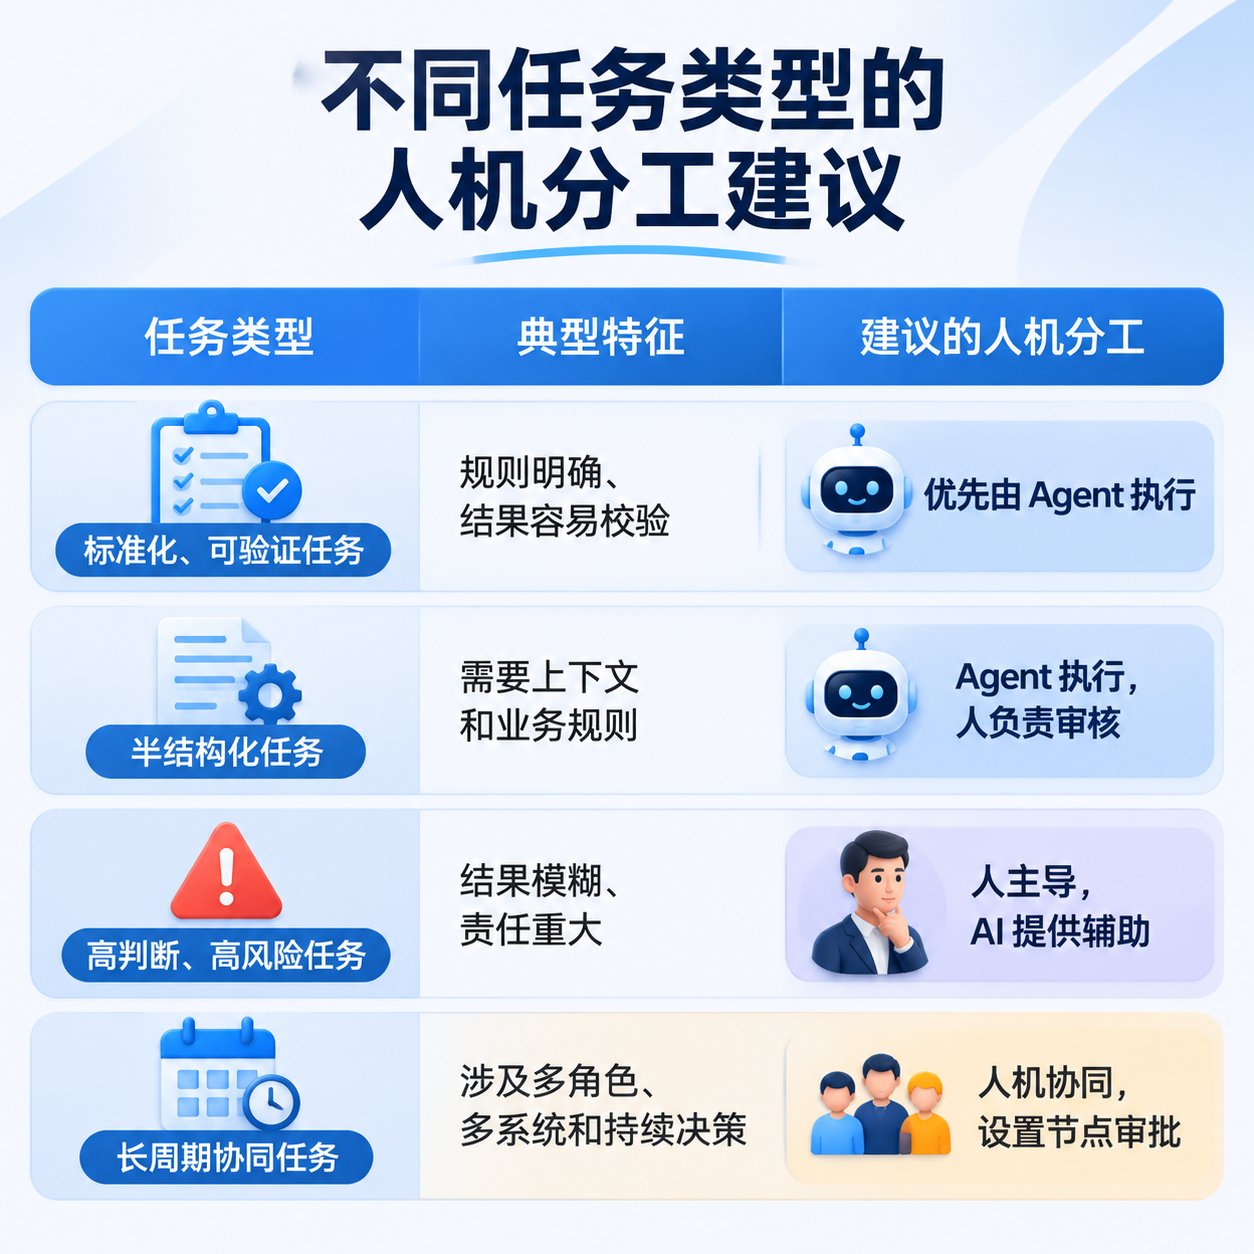
2. 人机分工编排:把能力嵌入真实业务流程
识别任务边界之后,下一步是将 AI 接入实际工作流。
例如,在营销与销售场景中,企业可以将线索识别、客户信息整理、内容生成、客户意向判断和跟进提醒等环节连接起来,让 Agent 承担重复的信息处理与标准化动作。
但涉及客户承诺、价格策略、重大商务判断和高风险决策时,应设置明确的人工确认节点。
真正有效的人机协作,不是让 AI 取代所有人,而是让 AI 接手适合自动化的工作,让人集中处理判断、关系和责任。
3. 建立企业上下文层:让模型理解企业自己的业务
模型可以通过通用知识完成大量任务,但企业经营需要的是对自身业务的理解。
客户是谁、产品有什么差异、价格和库存规则是什么、销售流程如何运行、哪些内容经过合规审核、不同部门之间如何协作——这些信息决定了 Agent 能否真正完成企业任务。
企业需要把分散的数据、知识、规则和流程整合起来,形成持续更新、可检索、可授权调用的企业上下文层。
这并不是简单地把更多文档上传到知识库,而是要建立知识与业务对象、业务流程和权限体系之间的关联。
4. 按业务结果度量:从 AI 使用量转向经营价值
企业不能只统计调用了多少次模型、创建了多少个 Agent、多少员工开通了 AI 账号。
更有意义的指标应该直接对应业务结果:
· 任务完成率与一次通过率;
· 单位任务成本与人工介入成本;
· 线索响应时长与有效转化率;
· 客户服务解决率与满意度;
· 业务流程周期与交付效率;
· AI 带来的增量收入、成本节约和利润贡献。
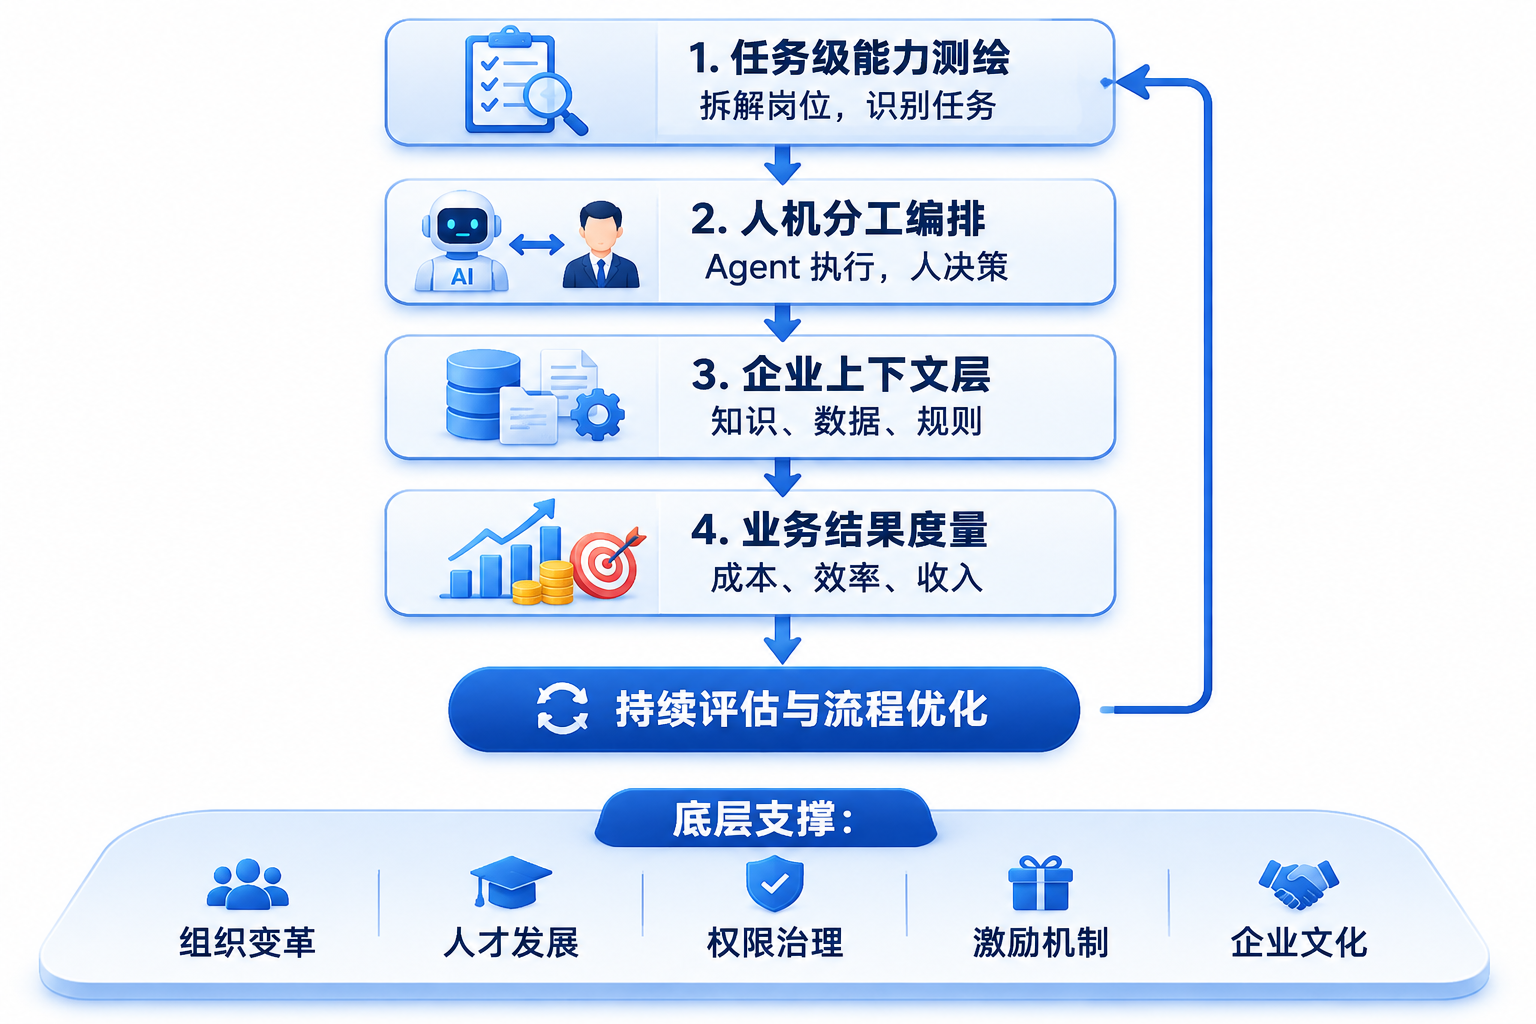
图 9|经营锯齿的四步闭环
这四个环节共同构成企业经营锯齿的基本方法:先识别任务,再组织协作;先让模型理解企业,再以经营结果验证价值。
八、迈富时 Marketingforce:把模型能力转化为企业流程资产
对于企业级 AI 服务商而言,锯齿前沿带来的机会,并不只是帮助客户部署更多模型或创建更多 Agent,而是帮助企业把模型能力转化为可持续运行的业务系统。
从这一视角看,企业级智能体基建需要重点解决四类组织问题:
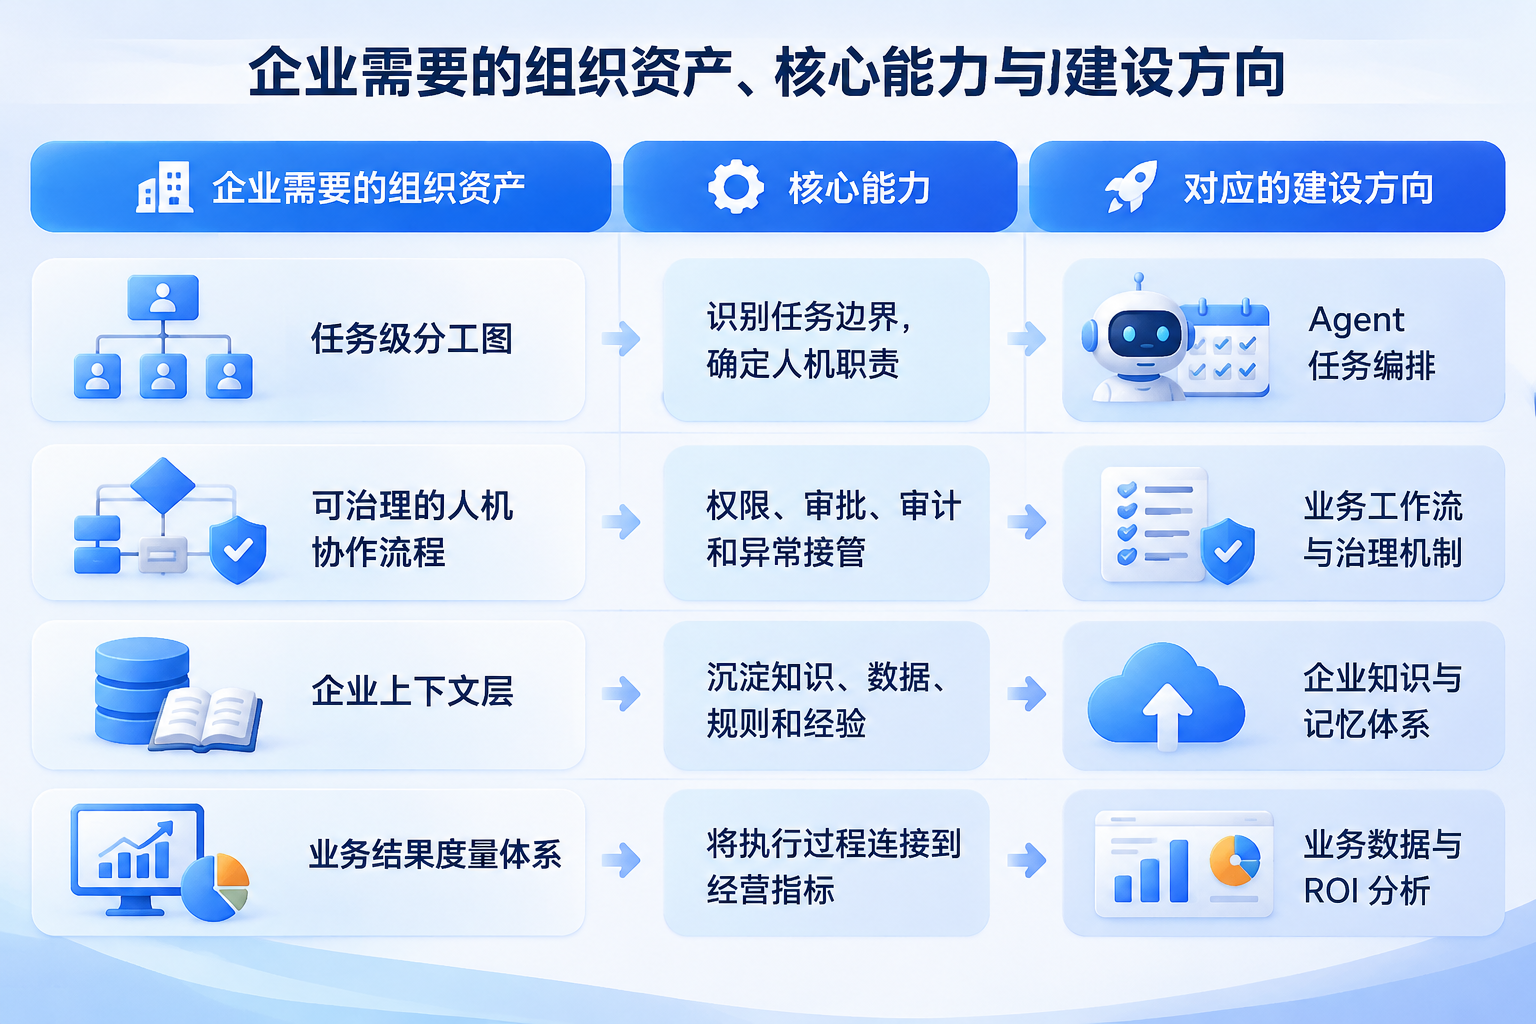
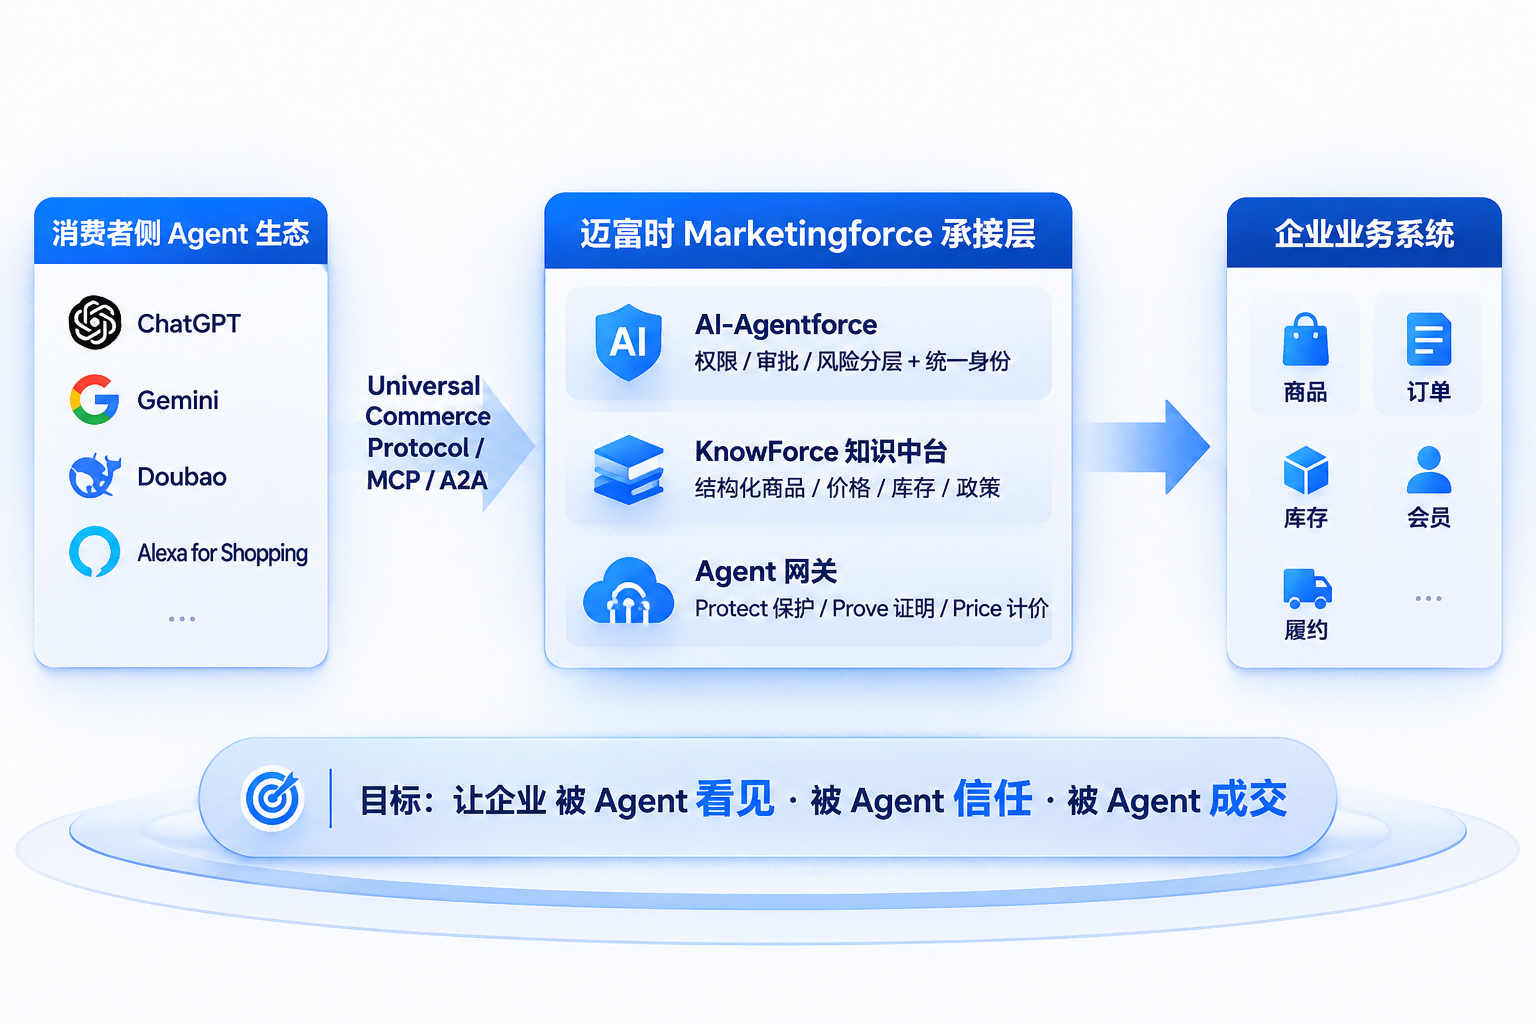
迈富时 Marketingforce 的企业 AI 建设思路,可以从两个关键能力方向理解。
AI-Agentforce:面向企业任务的智能体编排与执行。
企业需要的不只是能够回答问题的 AI,而是能够理解任务、调用工具、连接业务系统、执行流程并在必要时转交人工的智能体。Agent 的价值应当体现在任务完成、流程效率和业务结果上。
KnowForce:面向企业知识与上下文的组织记忆能力。
企业的产品知识、客户信息、业务规则、流程规范和历史经验,需要形成可持续更新、可按权限调用的知识资产。只有让 Agent 获取准确、及时且符合权限要求的企业上下文,模型能力才能真正进入业务场景。
二者共同指向一个方向:让企业不再依赖单一模型的能力,而是建立能够连接模型、知识、流程、工具和业务结果的企业级智能体体系。
当然,产品能力并不自动等于商业护城河。企业级智能体基建能否形成长期价值,仍需要通过实际经营指标验证。
建议重点观察四项指标:
· AI 相关收入的持续性:收入增长来自可复用产品和持续服务,还是主要依赖一次性项目交付。
· 客户续费率与净收入留存:客户是否持续将系统用于真实生产流程,是否不断扩大应用范围。
· 标准化产品与定制交付的毛利结构:能力是否能够产品化复用,还是主要依赖人力投入。
· 客户可归因的业务 ROI:在营销、销售、服务和经营分析等场景中,能否形成可被客户财务和业务部门共同验证的价值。
如果这些指标持续改善,企业智能体平台就有机会从 AI 工具集合,成长为真正的业务基础设施。
反之,如果 Agent 数量不断增加,却无法降低单位任务成本、提升流程效率或改善业务结果,平台就可能陷入“功能越来越多、经营价值却难以证明”的困境。
模型会持续迭代,企业真正需要沉淀的,是自己的任务分工、业务知识、流程规则和经营数据。
结语:企业的胜负手,不是预测 AGI,而是经营不均衡的能力边界
AGI 何时到来,今天仍没有可靠的时间表。
AAAI 的调查显示,学术共同体对单靠扩大当前 AI 研究路径实现 AGI 持审慎态度;METR 的研究则显示,AI Agent 在部分任务上的能力仍在快速扩展。两者并不矛盾:AI 能力可以持续跃升,但不意味着所有任务都会同步变得容易。
锯齿前沿揭示了 AI 能力的不均衡,NBER 的研究说明生产率收益在人群之间存在差异,OECD 的数据呈现出企业采用率的快速增长,而 McKinsey 和 Deloitte 的调研则进一步说明,从个人提效到企业规模化收益,仍然存在组织和流程层面的门槛。
与此同时,企业 AI 市场正在从模型能力建设走向应用落地,Agent 项目也开始面对成本、价值和治理的现实检验。
这些证据共同指向一个判断:
企业 AI 竞争的核心,正在从模型能力转向组织能力;从工具使用转向流程重构;从 Agent 数量转向可治理的业务生产率。
未来几年,模型还会变强,Agent 还会承担更多任务,企业的工作方式也会持续变化。但真正形成长期竞争优势的,不会只是最早接入某个模型的企业,而是能够持续识别任务边界、重构人
机分工、沉淀企业知识、控制执行风险,并用经营结果证明价值的企业。
别把企业 AI 战略押在 AGI 的时间表上。
把战略押在那张能够不断重绘、能够被业务验证、并且真正属于企业自己的任务分工图上。


 给我一个销售的联系方式


 登录

 沪公网安备31010902001233号