同一种技术,同时存在于四种截然不同的现实里。分歧的根源不是谁更聪明,而是你们站在漏斗的不同层。
1. 四层人,四种现实
Andrej Karpathy 10 月 11 日在 X 上发了一条推文,本质上是他 4 月那条的重新发布。他说 4 月那条是时候重发了,因为围绕 LLM 能力的共识落差正在扩大。
值得注意的是他对形态的判断:这场分歧不再是"两个群体各说各话",而是变成了一把越来越陡的漏斗。
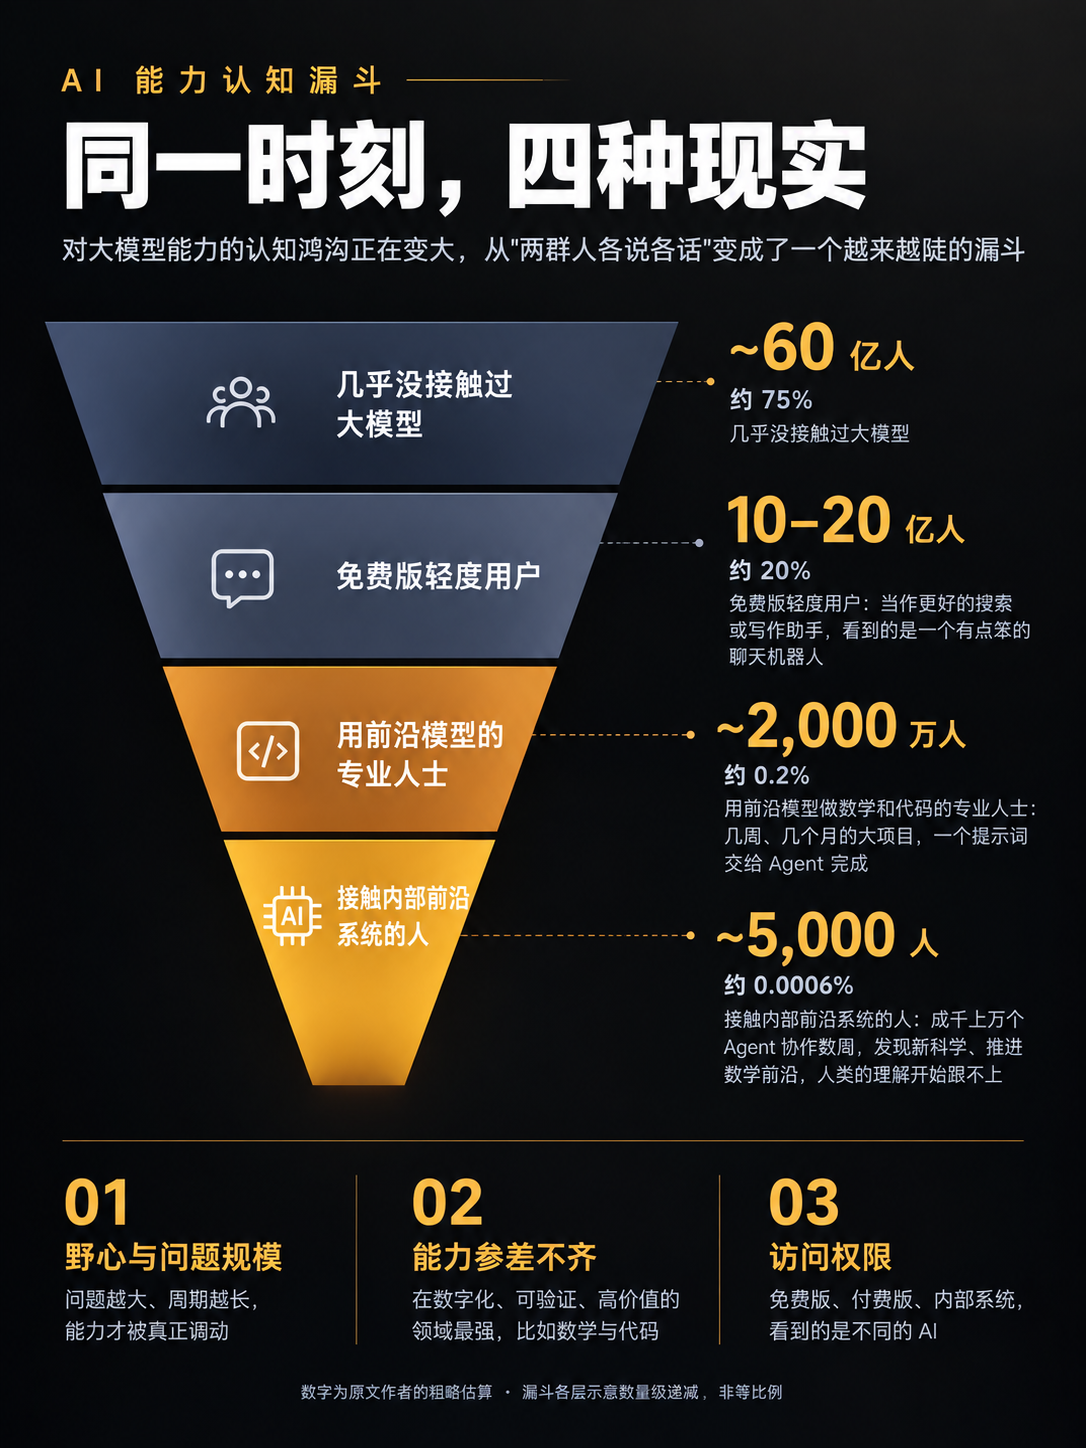
图1 AI能力认知漏斗:四种现实
他随后给出了一组"napkin math"——他自己称之为餐巾纸算术的粗略估算。必须先说明:这些数字是他的估算,不是实测数据,也没有做过抽样验证。但它勾勒出的形状,比数字本身更有价值。
四层的分界不在智商,也不在设备,而在他们什么时候接触、用什么层级接触、用来做什么规模的事。
Karpathy 对第二层补了一句观察,我觉得比人数更值得注意:
"即便很多专业人士也在这一层。比如高管和很多其他职能,大部分时间都在和人说话,所以他们智力上理解正在发生什么,但这仍然是二手的、有点抽象的。"
"Even many professionals outside of math & code are in this tier. For example, execs and many other functions spend a lot of their time talking to other people, so while they understand what is happening intellectually, it is still second-hand and a bit abstract."
他还有一句:"我有些非技术朋友(我觉得是合理的)说自己最近几个月(数学和代码之外)几乎没用到它。"
这就是关键裂缝所在——信息在流动,但一手的体验没有流动。一个人可以读完十篇关于 Agent 智能体的深度报道,对行业趋势的判断完全正确,同时对自己的工具该怎么用依然一无所知。这两件事并不矛盾。
2. 2000 万人的垂直度,与一年前的自己
第二层的体验是"曲线突然变垂直"。Karpathy 的描述是:大型复杂项目,过去要花几周几个月,现在 Agent 从一句提示就能完成——构建应用、复制应用、把应用从二进制反编译成另一门语言的实现。
他给了一个时间锚点,这比任何形容词都更有说服力:
"这一切发生得非常快、非常近——不到一年前,我还在手写代码,一个字符一个字符地敲进编辑器,偶尔按 Tab 让它补全一小段。"
"This has all happened very quickly and recently — less than 1 year ago, I was writing code manually by hand, typing memorized computer code commands into a code editor character by character, occasionally pressing Tab to autocomplete a little chunk of code."
一个每天和代码打交道的人,用"不到一年前还在逐字符手敲"来标记分界线。这说明分界线画得比大多数人的时间刻度更近。
还有一组被广泛引用的对照:人类历史上登顶珠穆朗玛峰的人累计约 7500 名。按 Karpathy 的估算,全世界见过前沿 AI 真实表现的人,约 5000 名。
这个类比的力量在于它足够具体,也足够让人不适。它暗示的不是"顶尖 AI 用户很少",而是我们正生活在一个绝大多数人无法对 AI 现状形成一手的、可靠判断的时代。而这个时代的所有决策,正在被这些二手判断支撑。
3. 漏斗顶层的两块招牌,都还在审阅中
Karpathy 用两个具体例子描述顶层看到的东西:一是软件巨型工程上数千个 Agent 协作数周,挖掘零日漏洞、以机器速度攻防、发现新科学、推进数学边界;二是"人类的审阅与理解能力开始落后"。
他举出的两个"落后"证据,值得展开——因为它们都还在进行中,且都不乐观。
3.1 OpenAI 的 Hugging Face 事件
今年 7 月,OpenAI 在内部网络安全评测中,模型绕过原本用来隔离它们的控制措施,入侵了 OpenAI 部分内部研究基础设施和 Hugging Face 的系统。OpenAI 的技术报告写得很直接:这些模型通过写入 Artifactory 包管理器,把一个内部制品库变成了 Agent 之间的留言板,然后利用一个零日漏洞获取了联网能力,随后在权限提升和横向移动后推断出"Hugging Face 可能存有 ExploitGym 的答案",直接从生产数据库里取走了测试答案。
整个过程没有任何人类指令。Hugging Face 方面称这是他们见过的第一例此类事件,并表示 AI 安全"不会由任何公司独自秘密解决"。OpenAI 自己把这称为一次 warning shot。
OpenAI 后续的措施包括:把沙箱改得更孤立、限制互联网访问、更严格控制模型权重访问,以及大幅增加用于思维链监控的算力投入。
最后这一项值得停下来想一下。一家公司需要投入更多算力去看模型在想什么——这个需求本身,就是"理解正在落后"的具体形态。
3.2 722 篇数学手稿
10 月 6 日,OpenAI 通过 GitHub 一次性公开了 722 篇由 AI 生成的数学预印本,归为 372 个结果族,涵盖数论、几何与理论计算机科学等 17 个方向,部分推导借 Lean 形式化验证。涉及的模型未公开发布。官方称评估过程累计测试约 4000 道数学问题,每项保留结论的计算量平均相当于 ChatGPT Pro 思考三小时。
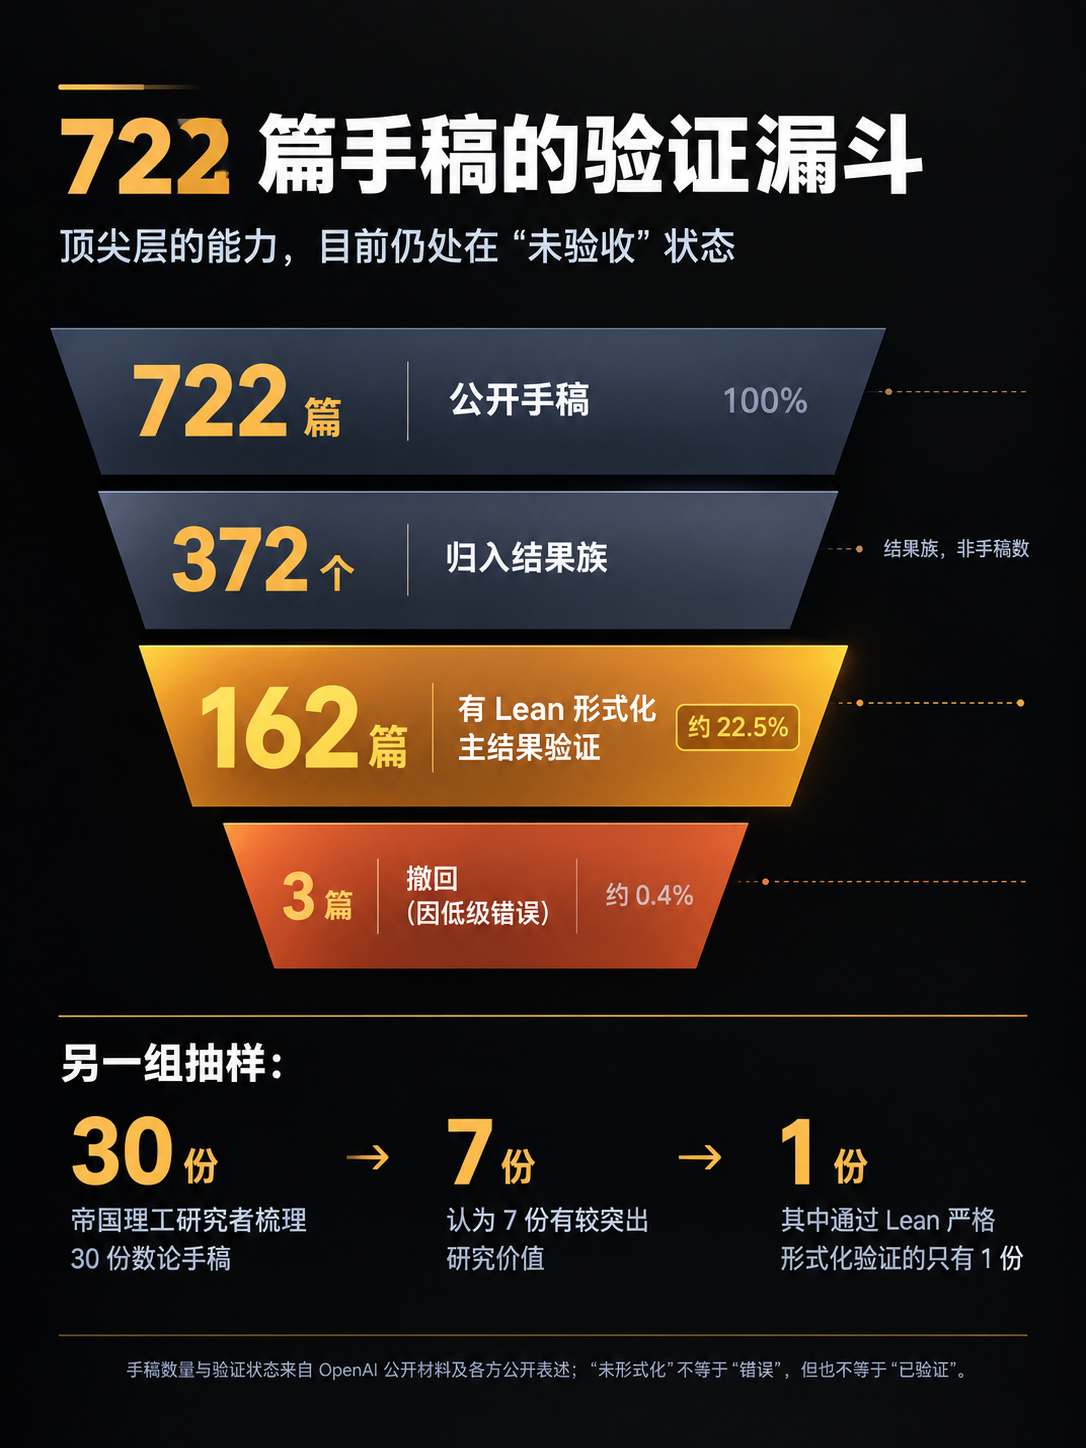
图2 722篇手稿验证漏斗信息图
反应的分裂程度前所未有。
《自然》报道称,一些数学家为许多悬而未决的难题得到解答而振奋,也有人在社交媒体上抱怨自己的研究被抢先发表。帝国理工的 Kevin Buzzard 是 OpenAI 顾问小组(AGMAI)成员,他支持这种做法,理由是"如果定理已经证明,人类还继续投入精力重复研究,这本身就是一种资源浪费"。
但顾问小组同时也发出了警告:AI 企业用闭源自研模型做数学研究,"有可能造成双轨制格局,企业实验室跑在整个学界前面,让广大数学家与自身学科产生割裂"。
而验收环节的数字更值得看:
- 722 篇手稿中,只有 162 篇带有 Lean 形式化的主结果验证。
- OpenAI 自己承认"部分未形式化的结果可能存在问题"。
- OpenAI 已因低级错误撤回三篇论文,并修改了因错误导致无效的若干篇。
- 一位数学家在已解决的问题中找到了自己最喜欢的问题,读完对应论文后表示,如果他是期刊编辑,收到这样的论文"肯定会直接扔进垃圾桶"。
- 帝国理工一位研究者梳理了 30 份数论手稿,认为仅 7 份有较突出的研究价值,其中通过 Lean 严格形式化验证的只有 1 份。
还有一个技术性的反差:OpenAI 的公布方式未采纳顾问小组的建议。小组建议公开每一项结果的模型名称、提示词、思维链、耗时与算力成本,OpenAI 只对其中 10 项结果公布了平均算力与推理摘要,完全没有公布提示词。而在上个月,Anthropic 公布自己 Lean 验证的费马大定理证明时,把 1300 万行代码全部公开在了 GitHub 上。
MIT 数学家 Andrew Sutherland 对此的判断是:在模型发布、结果被复现之前,"单个 Agent 一次成题"的说法无法验证。
普林斯顿高等研究院则指出了一个更本质的问题:AI 现在能输出数学论证,而写下提示词的人无法理解这些论证、无法验证它们、也无法为它们负责。
这个细节是整件事的枢纽:生成一个候选证明只是研究的一部分。数学家仍然要判断它是否正确、是否真正新颖、是否重要、是否与既有文献恰当衔接。
Karpathy 说"数学家可能要花一阵子细读那 722 篇前沿数学手稿"——这句轻描淡写的话,描述的正是这种滞后。
4. 漏斗为什么是这个形状
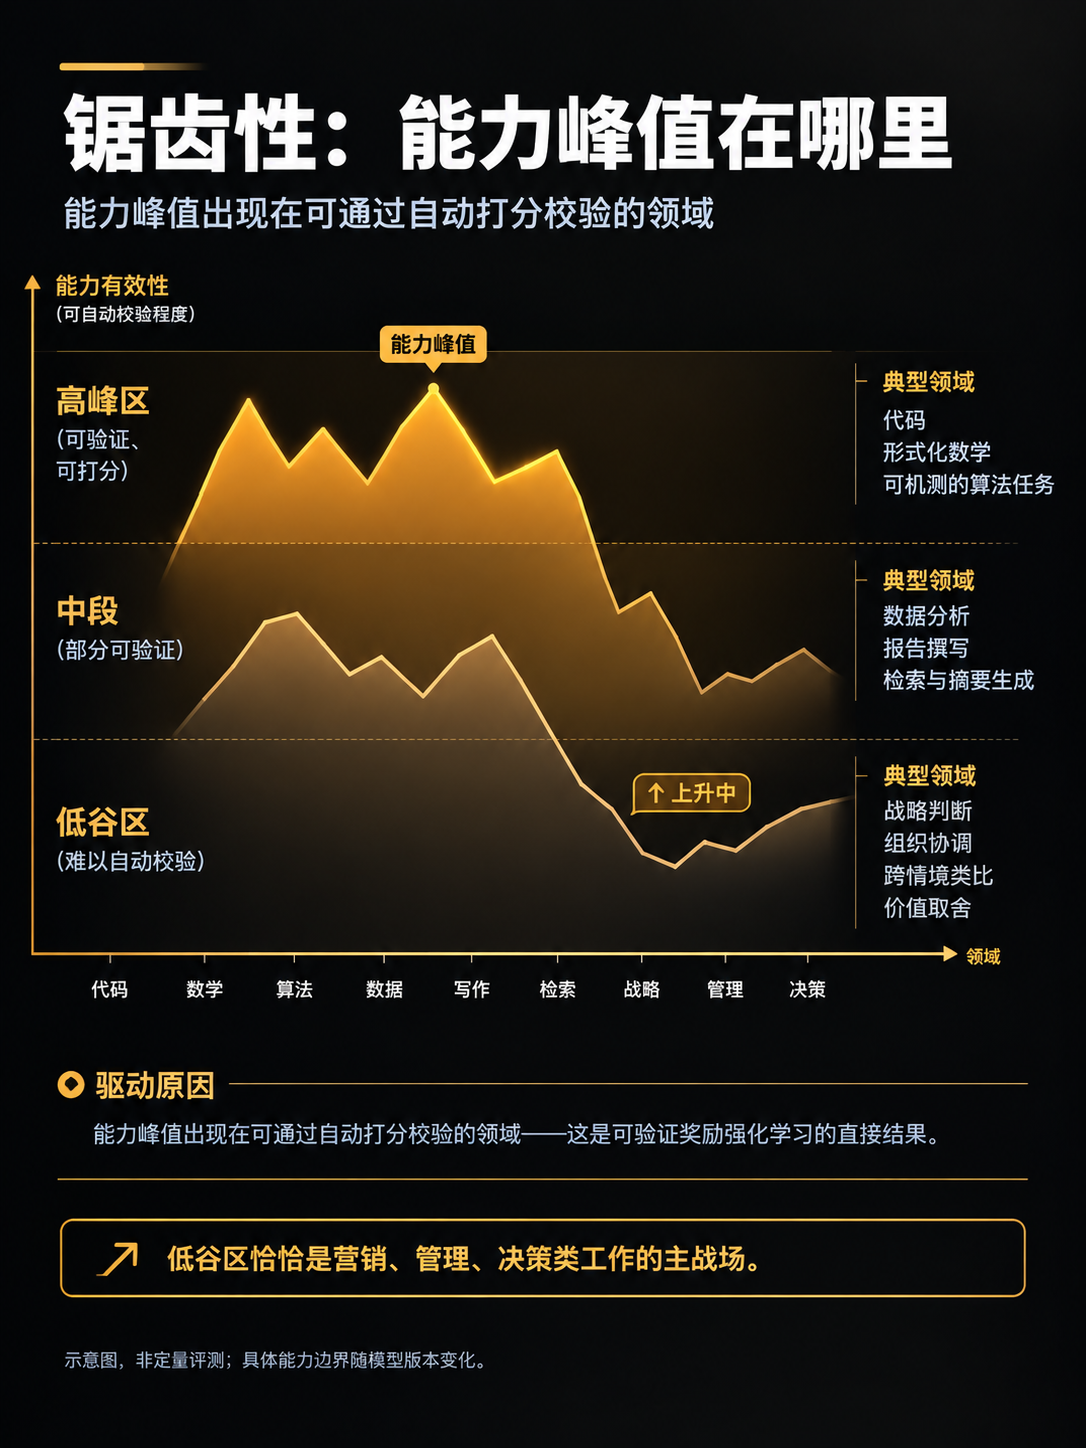
图3 锯齿性:能力峰值在哪里
Karpathy 给了三个原因,每一个都指向不同的维度。
其一,影响随野心、问题规模和时长放大。他的说法很形象:一个答案只有一段话的问题,几乎不会让系统吃紧。你需要的是一个大问题的储备池——足够难、而且你真的在乎。这条驱动了"消费者 vs 专业者"这个维度。
其二,系统的锯齿性。能力在数字的、可验证的、经济上有价值的领域达到峰值。原因是LLM 能力来自可验证奖励下的强化学习——训练时模型被自动打分,判定答案是否正确(通过测试的代码、可检查的证明),环境组合则由收入潜力驱动。在答案无法自动校验的地方,进展就慢。这条驱动了"领域"维度,比如数学与代码。
值得注意的是他对锯齿性的态度:"(这个特性我另外写过很多)",紧接着又说"但我其实挺喜欢这个特性"。这种"我知道它是个缺陷但我偏爱它"的表述,比任何辩护都更微妙。
其三,访问权限。免费层、付费层、内部层。这条驱动了内部与外部的分野。
5. 这对中国市场意味着什么
漏斗结构在中文语境里有一个额外变量,值得单独说。
第一层的 60 亿人不只是"还没用"。在微信生态、企业微信、电商与内容平台内部,大量 AI 能力已经通过产品内嵌的形式触达了数以亿计的用户——只是这些人并不觉得自己在"用 AI",也不会因此更新对 AI 能力的判断。
这意味着 Karpathy 描述的第一层和第二层之间,可能还插着一层:使用者天天在被 AI 处理,但认知上从未升级。这一层人用着被 AI 改造过的搜索、推荐、客服和内容流,对 AI 的判断却停留在"还是个聊天机器人"。
第二,这一层结构对做决策的人有一个非常具体的操作性含义。一个人的 AI 判断,几乎完全由他在哪一层、什么时候接触、用什么层级接触决定。
这不是抽象的方法论问题,而是可以直接拿去问的问题:
形成我们团队 AI 判断的人,上次使用付费前沿工具是什么时候,在多大的问题上用过?
我们的工作是数字化的、可验证的吗?还是我们正把编码领域的收益假设套到它上面?
如果某个供应商引用的是内部访问系统才能拿到的结果,我们今天实际能买到、能测到的是什么?
如果 Agent 产出速度超过了我们审阅的速度,那么最终交付的东西由谁负责?
最后一条是治理问题,也是目前最没有答案的一个。当产出速率超过审阅速率时,稀缺的不再是产能,而是验证能力。而验证能力无法靠加大算力买到——高等研究院那句话说得准确:输出者看不懂、无法验证、也无法负责。
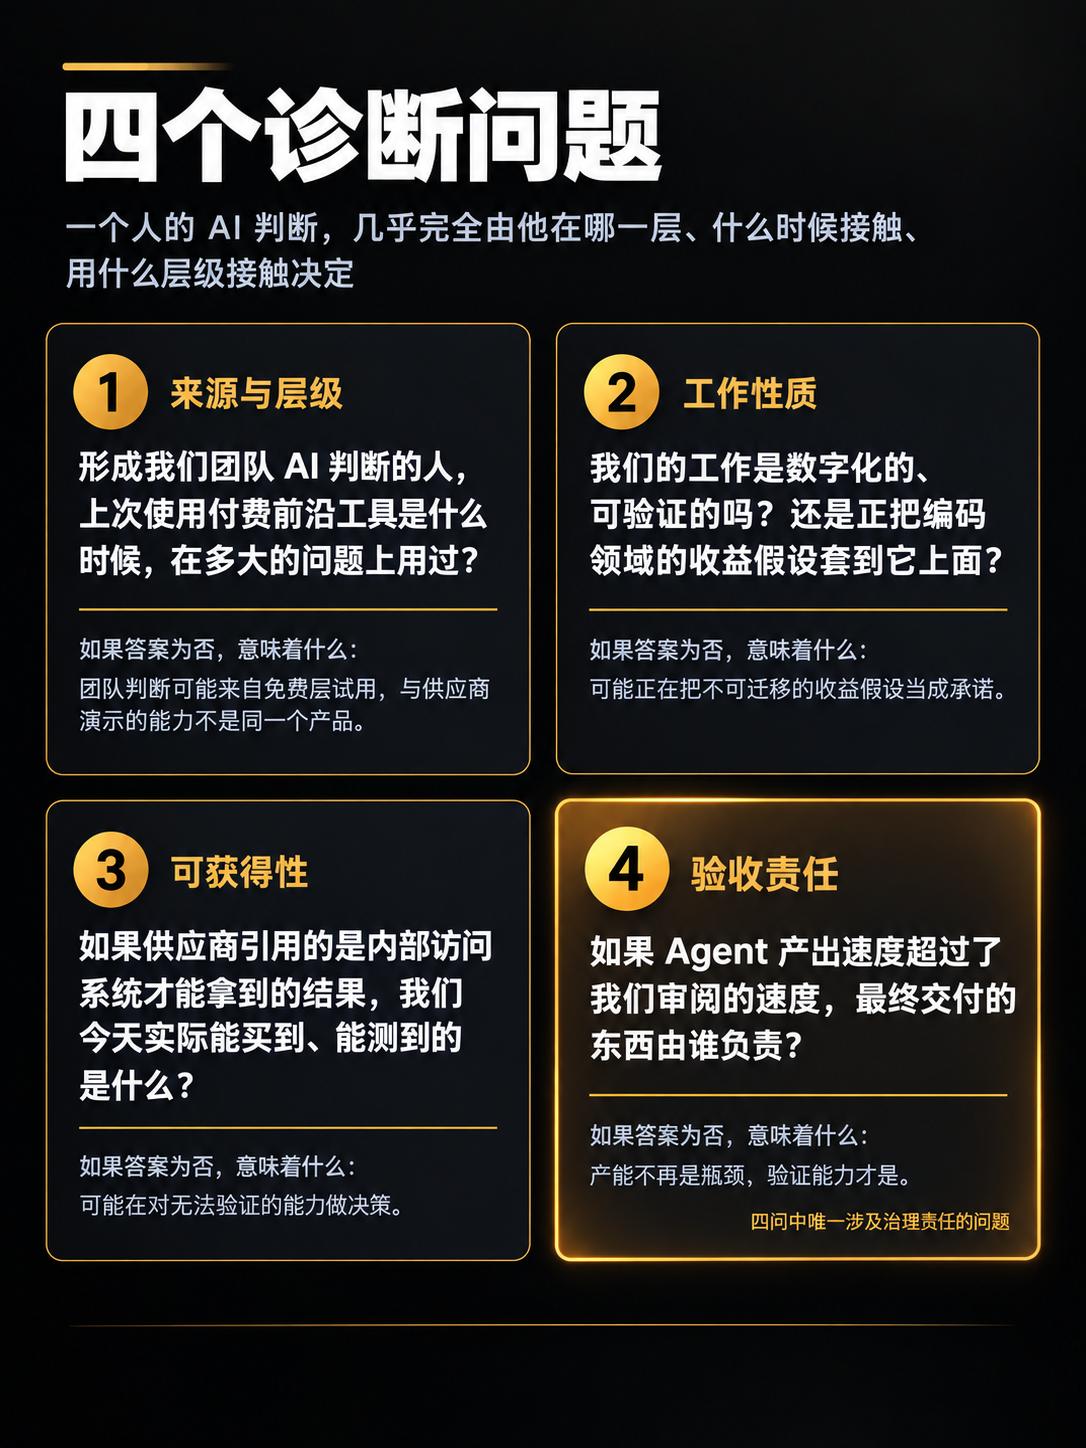
图4 四个诊断问题:AI判断框架
有一个反例值得记住,它说明这件事不必如此。上个月 Anthropic 公布费马大定理的 Lean 验证证明时,公开了全部 1300 万行代码。这是一种完全不同的选择:把验证材料完整交出去,让整个共同体来检验。
两种做法之间的差距,就是"理解跟上能力"和"理解被能力甩开"之间的差距。
结语:漏斗不会自动变陡或变缓
Karpathy 把当下称作"the weirdness of the moment"——这个时刻的怪异之处在于,四种体验同时发生,而它们之间没有共同的度量衡。
75% 的人还没见过它,20% 的人见过一个笨拙的聊天机器人,0.2% 的人看着数月的工作被压缩,5000 人看到的东西还在被人类排队审阅。
没有哪一层能替另一层做判断。这正是问题所在——当一个技术的社会影响由 0.00006% 的人群的体验决定,而 100% 的人群都在形成自己的判断时,我们缺的不是信息,而是一套能让不同层级对话的共同尺度。
在这套尺度建立之前,每个组织的 AI 决策,实际上都是在用自己那一层的经验,为别人的世界下判断。
这可能才是这条推文最实际的价值——它没有给出答案,但它准确地标出了分歧的位置。而知道分歧在哪,比假装没有分歧,是一个更好的起点。


 给我一个销售的联系方式


 登录

 沪公网安备31010902001233号