引言:智能体的“阿喀琉斯之踵”
如果说2024年是AI智能体(Agent)的概念萌芽之年,那么2026年无疑是其走向规模化落地的关键转折点。从自动化编程到企业级流程编排,智能体正试图从“对话玩具”进化为“生产力工具”。
然而,在DeepSeek-V4及同期发布的多模态模型问世之前,智能体的发展始终面临一道隐形的天花板:感知与推理的断裂。
传统的智能体架构中,模型往往扮演“大脑”的角色:它接收用户指令,进行任务拆解,调用外部工具。
但当环境信息(如一张复杂的图表、一个拥挤的监控画面、一份图文混排的财报)需要被理解时,大多数纯文本模型只能依赖外部OCR或图像描述模型进行“翻译”,这一过程极易造成信息失真。
正如DeepSeek最新技术论文所指出的,现有的多模态大模型存在严重的“指代鸿沟”——它们能“看见”,却很难在复杂的逻辑推理中“指得清”。
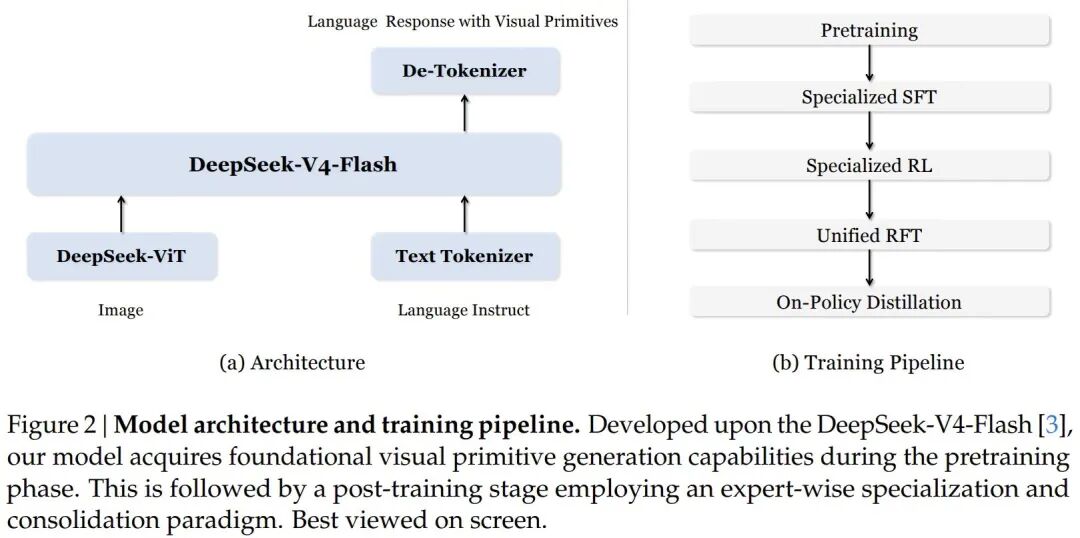
如今,随着DeepSeek原生多模态大模型“Thinking with Visual Primitives”范式的提出,以及DeepSeek-V4在Agent能力上的专项优化,这一局面正在被根本性地改写。
在本篇文章中,迈富时将从架构演进的视角,深度剖析DeepSeek的多模态技术突破将如何从“视觉锚定”、“推理深化”与“记忆扩展”三个维度,全面提升智能体的能力上限。
一、 视觉锚定:从“模糊感知”到“像素级精准”的智能体交互
在智能体处理现实世界任务时,视觉理解是绕不开的一环。假设你希望一个智能体帮你统计“监控画面中所有佩戴安全帽的工人”,或者“在电路图中找到连接电阻R1和电容C2的路径”,传统的智能体通常会陷入困境。
根本原因在于“语言的模糊性”。
人类用“左边那个”、“红色区域”来描述物体,但这对于机器而言是极不精确的。
DeepSeek多模态模型提出的核心创新——“Thinking with Visual Primitives”,正是为了解决这一问题。
1. 将坐标纳入思维链
区别于传统模型仅将坐标作为输出结果,DeepSeek的突破在于让坐标(边界框和点)成为了推理过程的基本单位。在模型的内部思维链中,当提到某个物体时,模型会同步输出其精确的坐标锚点。
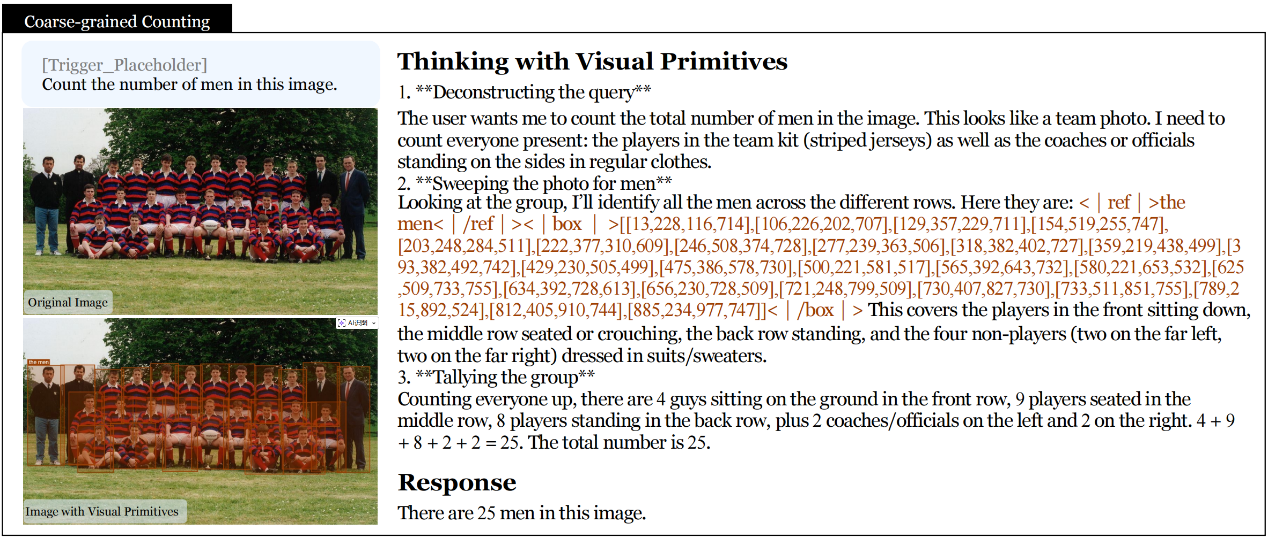
例如,在统计人群时,模型不再模糊地猜测,而是像人类用手指点着数一样进行推理:“扫描到第一组人群`<|box|>[[x1,y1,x2,y2]]`,共计5人;移动到右侧第二组人群`<|box|>[[x3,y3,x4,y4]]`,共计3人,总计8人”。
这对智能体意味着什么?—— 可执行的环境感知。
当DeepSeek多模态模型作为智能体的“感官中枢”时,它输出的不再仅仅是“图片描述”,而是“结构化的、带有绝对坐标的环境数据”。
对于下游的智能体执行单元而言,这意味着它可以直接将这些坐标传递给机械臂、鼠标光标或图像编辑工具。智能体由此完成了从“我看到了什么”到“我知道具体在哪里操作”的闭环。
2. 超高压缩下的细节保留
为了支撑这种精度,DeepSeek在工程上实现了惊人的“7056倍视觉压缩比”。通过ViT加3x3空间压缩,再配合V4内置的稀疏注意力机制,一张高分辨率图片的KV缓存仅需约81个条目。
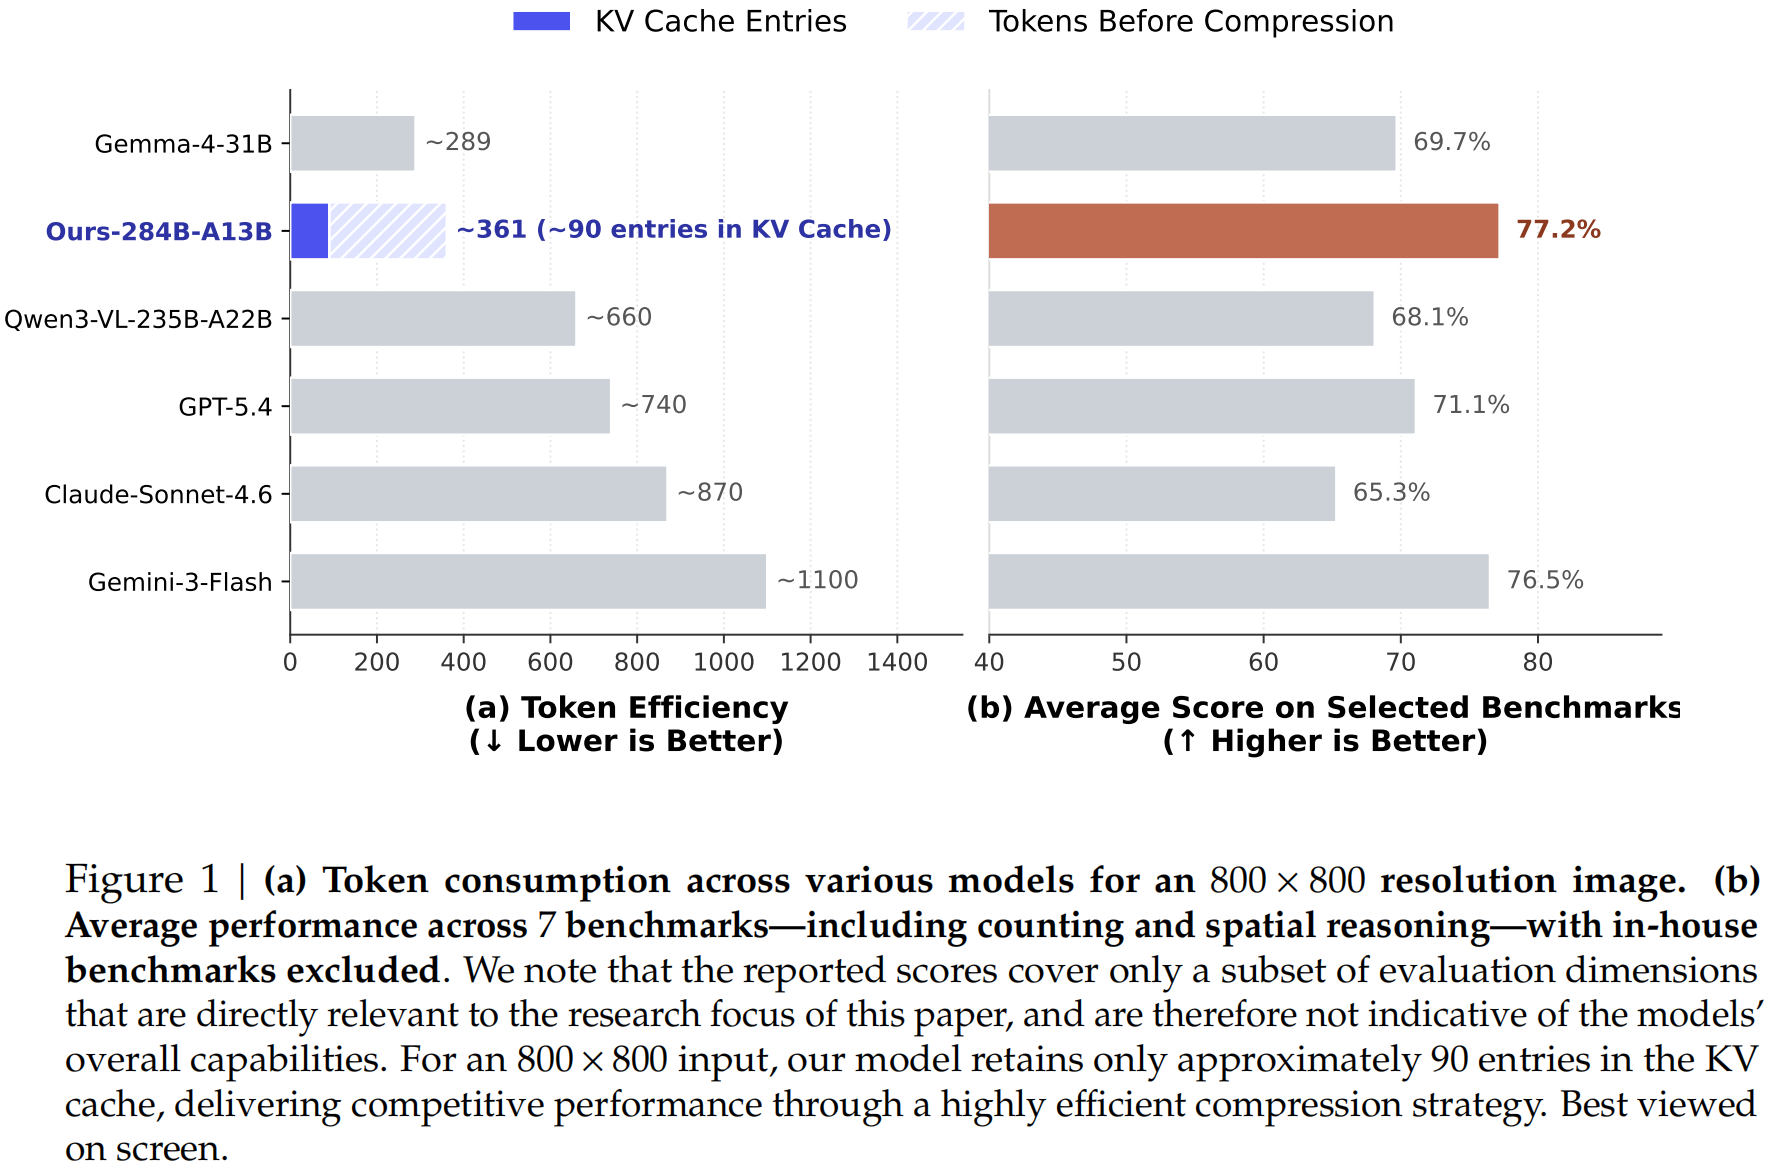
这意味着智能体在处理高分辨率图像(如4K监控或高清医疗影像)时,占用的显存和计算资源极低。
对于企业级智能体而言,这直接转化为“更低的API调用成本”和“更快的首字响应时间”,使得实时视觉智能体(如实时质检、实时导航)的商业化落地成为可能。
二、 推理深化:双模式架构与复杂任务的“降维打击”
视觉锚定解决了“输入精度”的问题,而DeepSeek-V4则在“大脑处理”层面为智能体带来了质的飞跃。
如果说视觉模型提供了“眼睛”,那么V4作为语言基座,提供了“前额叶皮层”。根据DeepSeek官方技术报告,V4系列在Agent能力上进行了专项优化,特别是在逻辑拆解与工具调用方面。
1. 思考模式:透明化的决策逻辑
DeepSeek-V4同时提供了“DeepSeek-Chat(非思考模式)”和“DeepSeek-Reasoner(思考模式)”。在智能体执行高复杂度任务(如根据草图自动生成代码、编写复杂的SQL查询)时,“思考模式”展现出完整的思维链推导过程。
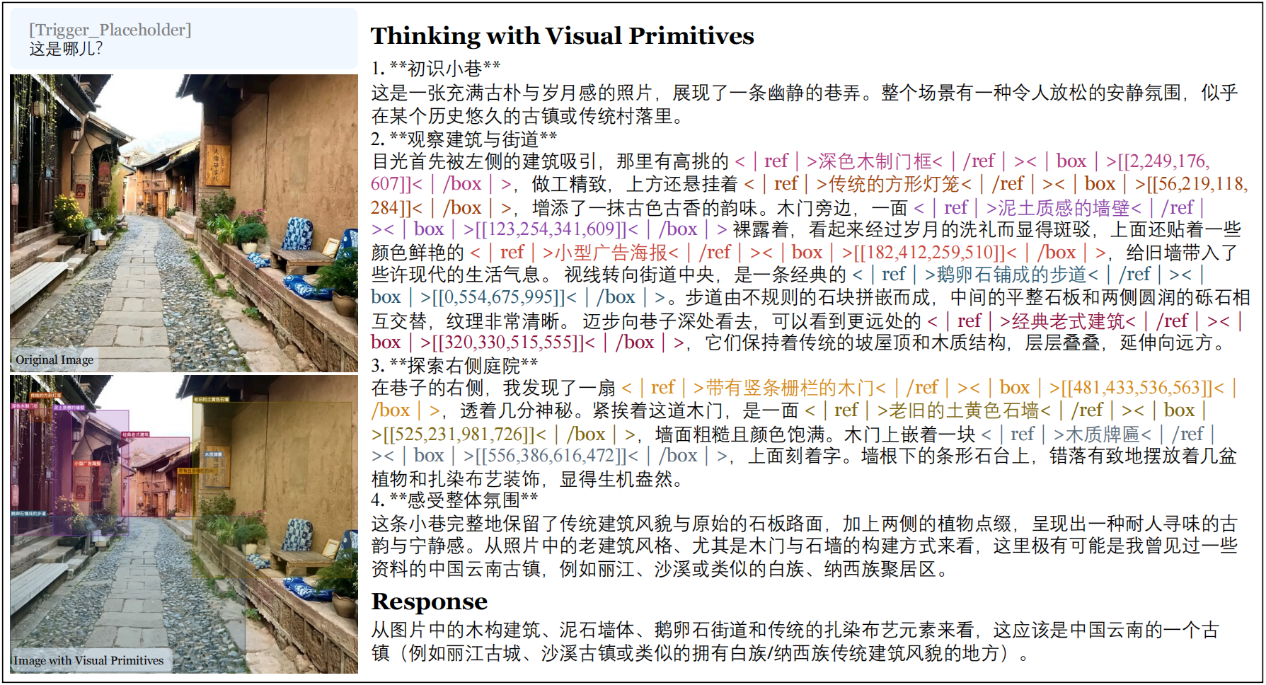
这种设计让智能体不再是“黑盒”。当智能体出错时,开发者可以通过回溯其推理路径(比如“模型是否混淆了视觉中的两个元件?”)来进行精准调试。这种透明度对于金融、医疗等高风险领域的智能体审计至关重要。
2. 强约束的工具调用
在MCP(模型上下文协议)和工具调用(Tool Calling)成为主流的今天,智能体需要频繁调用外部API。DeepSeek-V4新增的“strict模式”支持,是智能体工程化的一大福音。
以往的模型在输出函数参数时,容易产生格式错误或参数缺失(例如,查询天气时必填的“城市”字段可能被忽略)。V4能够严格遵循预定义的JSON Schema。
结合其多模态能力,智能体可以做到:看一眼用户的便签图片 -> 提取关键信息 -> 严格按照日历API的参数格式创建明天下午3点的会议。
这种从“非结构化输入”到“结构化指令”的丝滑转换,是智能体替代人工操作的关键技术桥梁。
三、 记忆扩展:百万上下文中的“全貌决策”
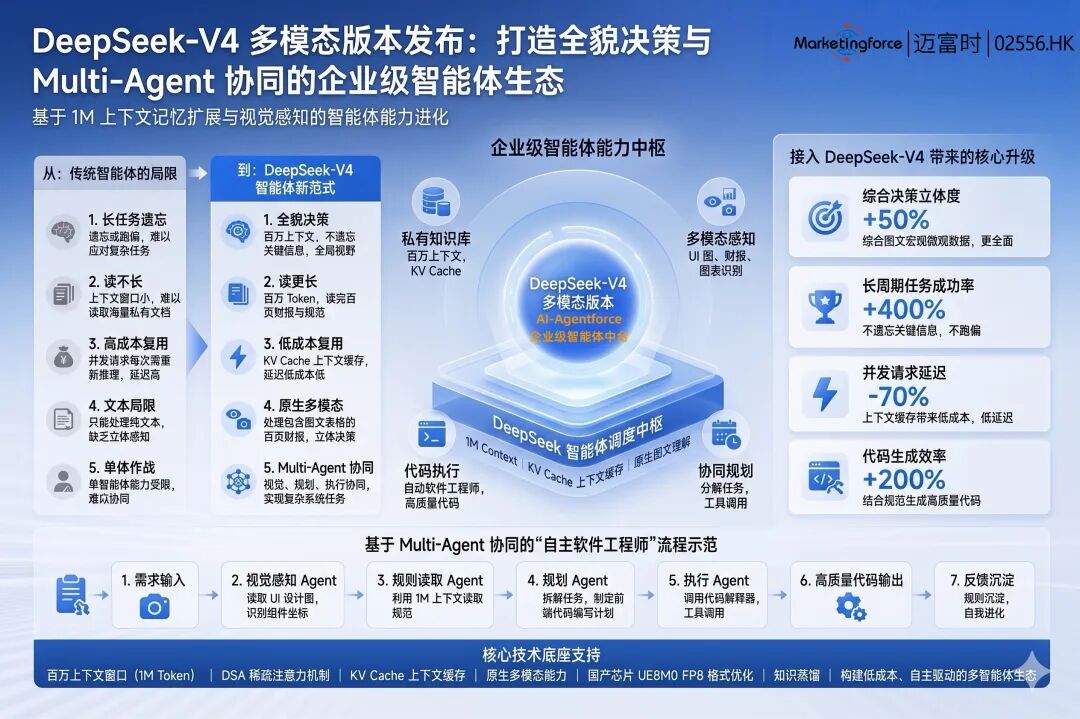
智能体往往在长周期任务中表现出“遗忘”或“跑偏”。DeepSeek-V4将上下文窗口提升至1M token(Pro版本),并结合DSA稀疏注意力机制,在保证效率的前提下,让模型能够一次性记住海量信息。
对于智能体,这一提升不仅在于“读得长”,更在于上下文缓存带来的低成本复用。
在构建企业级智能体时(如架构师设计的“AI员工”),常常需要处理海量的私有文档。V4的上下文缓存机制允许智能体将固定的业务规则(如公司的报销制度、代码库规范)缓存在KV Cache中。当处理后续并发请求时,成本大幅降低且延迟显著减少。
更进一步,结合原生多模态能力,V4能够一次性处理包含图文、表格的百页财报。智能体由此具备了“全局视野”,可以在进行市场分析时,同时引述文本中的宏观趋势、表格中的财务数据和图表中的增长曲线,得出比纯文本模型更全面、更立体的决策建议。
四、 范式重构:Multi-Agent协同与未来生态
最后,我们不能孤立地看待视觉模型和V4,它们是同一枚硬币的两面。
DeepSeek的知识蒸馏能力和为国产芯片优化的“UE8M0 FP8格式”,预示着高昂的多模态推理成本正在被技术普惠所取代。
当算力门槛降低,多智能体系统将迎来爆发。
以迈富时服务的一个典型研发应用场景为例:
1. 视觉感知Agent(基于DeepSeek多模态):读取UI设计图,识别其中的按钮、输入框及其坐标。
2. 规划Agent(基于V4思考模式):将UI设计图拆解为前端代码编写任务。
3. 执行Agent(基于V4工具调用):调用代码解释器,利用1M上下文读取项目现有的代码规范,生成高质量的前端代码。
DeepSeek多模态的发布,不仅仅是迭代了一个模型版本,更是构建了一个从“看懂世界”到“改变世界”的技术闭环。对于企业而言,这意味着构建具有“像素级精度”和“长周期逻辑”的智能体从未如此容易。
迈富时的企业级智能体也正在从单纯的“信息处理者”,进化为真正的“物理世界与数字世界的操作者”,企业级智能体的能力新边界,已被重新定义。


 给我一个销售的联系方式


 登录

 沪公网安备31010902001233号